
Qwen Image 3.0: Contenuti ricchi, dettagli autentici e conoscenza profonda
Qwen Image 3.0 è il modello di generazione immagini AI di terza generazione di Alibaba, rilasciato il 21 luglio 2026 con l’ID modello qwen-image-3.0-pro. Accetta prompt fino a 4.500 token, riproduce il testo con precisione fino a 10 pixel e supporta nativamente 12 lingue — caratteristiche che lo distinguono dalle versioni precedenti e dalla maggior parte degli strumenti concorrenti. Il team Qwen ha costruito questo modello attorno a un unico principio: rendere le immagini generate dall’AI genuinamente impiegabili come strumenti di produttività, non semplici output visivamente impressionanti.
Mentre Qwen-Image-1.0 si concentrava sulla precisione e Qwen-Image-2.0 si espandeva a completezza e varietà, Qwen Image 3.0 è definito da una sola parola: Real (实). Ciò significa infografiche con testo in corpo minuto leggibile, etichette di prodotto multilingue che si visualizzano correttamente in ogni sistema di scrittura, e mockup di interfacce abbastanza accurati da utilizzare nelle presentazioni ai clienti — tutto generato in un singolo passaggio senza post-elaborazione.
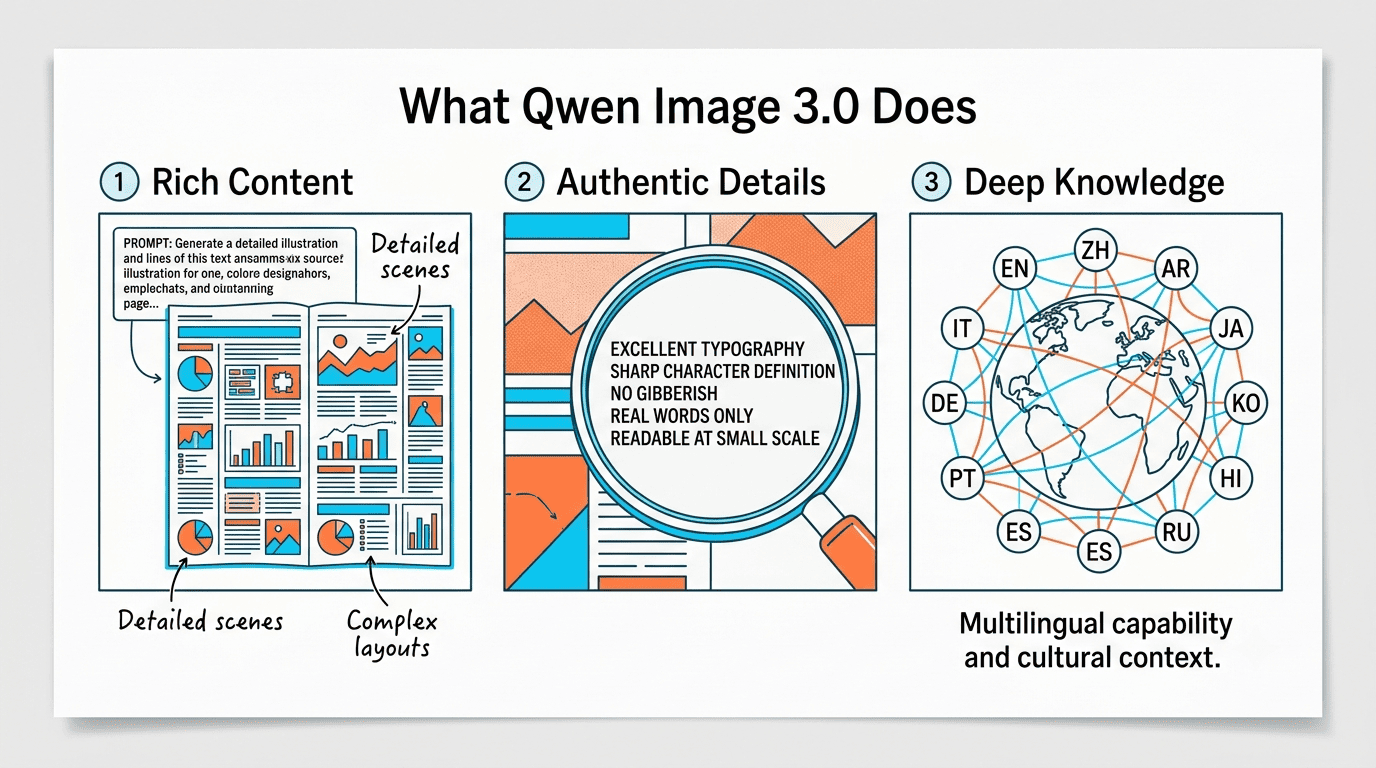
Che cos’è Qwen Image 3.0?
Qwen Image 3.0 è un modello fondazionale di generazione immagini chiuso, accessibile solo tramite API, sviluppato dal team Qwen di Alibaba. È accessibile come qwen-image-3.0-pro attraverso le API QwenCloud e DashScope, e tramite l’interfaccia no-code su chat.qwen.ai. A differenza del suo predecessore Qwen-Image-1.0, distribuito con pesi aperti Apache 2.0, la versione 3.0 è un sistema proprietario — nessun peso è disponibile per l’hosting autonomo.
Il posizionamento dichiarato dal team Qwen è esplicito: questo modello di generazione immagini di Alibaba non persegue l’estetica per se stessa, ma output “utili” — immagini da impiegare direttamente in pipeline di marketing, flussi di lavoro di design e sistemi di produzione dei contenuti senza cicli iterativi di pulizia.
La serie Qwen-Image in sintesi
La terza generazione è il culmine di un arco di sviluppo di circa un anno:
| Versione | Rilascio | Tema | Traguardo principale |
|---|---|---|---|
| Qwen-Image 1.0 | Ago 2025 | Precisione | 20B MMDiT, pesi aperti (Apache 2.0), report arXiv |
| Qwen-Image-2512 | Dic 2025 | Realismo | Volti umani e texture migliori; #1 open-source su AI Arena |
| Qwen-Image-Edit-2511 | Dic 2025 | Editing | Editing avanzato delle immagini, input multi-immagine |
| Qwen-Image 2.0 | Feb 2026 | Completezza | Prompt da 1k token, risoluzione nativa 2K, architettura più leggera |
| Qwen Image 3.0 | Lug 2026 | Real (实) | 4.500 token, testo a 10px, 12 lingue, generazione con accesso al web |
Contenuti ricchi: fino a 4.500 token in un singolo passaggio
La capacità strutturalmente più significativa di Qwen Image 3.0 è la lunghezza del prompt: il modello accetta fino a 4.500 token in una singola richiesta di generazione — 4,5 volte il limite di 1.000 token di Qwen-Image-2.0. A questa lunghezza, un singolo prompt può descrivere nove pannelli infografici specificati in modo indipendente, completi di didascalie, vincoli di layout, palette di colori e direttive tipografiche, e ricevere l’immagine multi-pannello completata in un solo passaggio.
Questo è importante perché l’alternativa — generare i pannelli singolarmente e poi comporli — introduce incoerenze visive: pesi del carattere non corrispondenti, valori di colore leggermente diversi e dimensioni degli elementi inconsistenti. La generazione in singolo passaggio con un prompt unificato da 4.500 token elimina questi problemi alla radice.
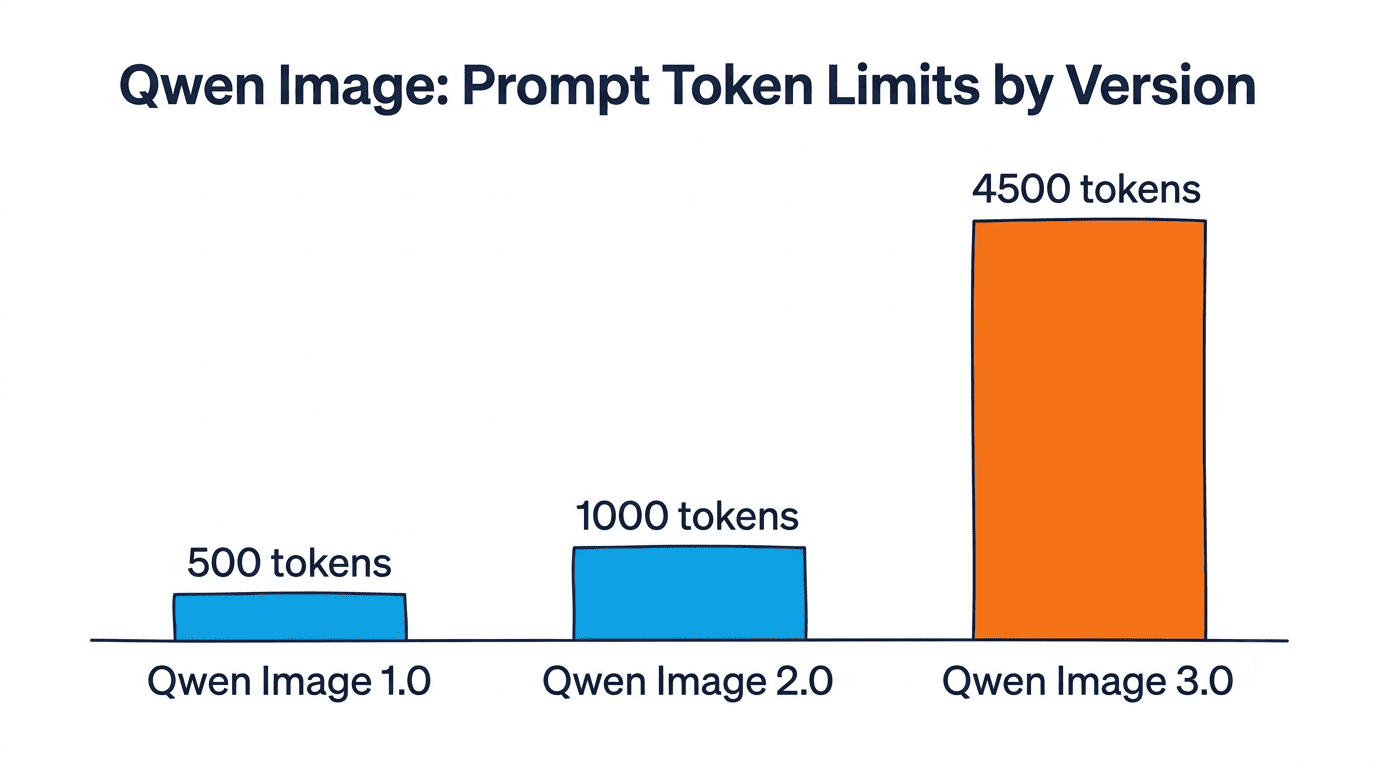
I casi d’uso reali che questo rende possibili sono notevoli. Pagine intere di giornale, storyboard multi-pannello, menu di ristoranti con testi dettagliati per ogni voce e compiti d’esame multipagina — tutto ciò che in precedenza richiedeva flussi di lavoro a più fasi. Qwen Image 3.0 li comprime in una singola chiamata API.
Layout ad alta densità di informazioni e strutture annidate
Oltre alla lunghezza grezza del prompt, il generatore di immagini Qwen gestisce una complessità visiva con cui altri modelli faticano: immagini all’interno di immagini (picture-in-picture) fino a più livelli di annidamento, griglie infografiche 3×3 in cui ogni cella è specificata in modo indipendente, formule matematiche LaTeX rese inline con il testo circostante, e diagrammi di derivazione logica.
Si consideri un esempio pratico: un banner pubblicitario di prodotto contenente lo screenshot di un’app mobile (che mostra a sua volta un’interfaccia dashboard live) con una didascalia esplicativa e una nota in corpo minuto in fondo. Si tratta di un layout annidato su tre livelli — Qwen Image 3.0 lo produce da un singolo prompt dettagliato.
Casi d’uso che beneficiano maggiormente di questa capacità di layout denso:
- Caroselli per social media e infografiche multi-pannello
- Documentazione tecnica con diagrammi e formule incorporati
- Materiali di marketing con relazioni complesse tra testo e immagine
- Schede di esercizio, flashcard e compiti d’esame a scopo didattico
Dettagli autentici: testo a 10px e qualità fotografica
Resa precisa del testo
Qwen Image 3.0 riproduce il testo con precisione a 10 pixel — una soglia che rende possibile produrre avvertenze legali leggibili nei mockup di packaging di prodotto, testo in corpo minuto nelle visualizzazioni di documenti finanziari e riferimenti a note a piè di pagina nei poster accademici. Dieci pixel corrispondono approssimativamente alla dimensione alla quale i caratteri standard a schermo diventano difficili da leggere per l’occhio umano; il fatto che il modello possa generare lettere corrette a questa dimensione rappresenta un divario di capacità significativo rispetto ai modelli che sfocano o corrompono il testo al di sotto dei 20-30px.
Questo si basa su una competenza fondamentale della serie Qwen-Image fin dall’inizio. Il modello originale 1.0 aveva introdotto una resa affidabile dei caratteri cinesi e inglesi; la versione 2.0 l’aveva estesa a layout infografici professionali con prompt da 1k token. La versione 3.0 porta lo standard di precisione alla qualità quasi da stampa con dimensioni minime dei caratteri.
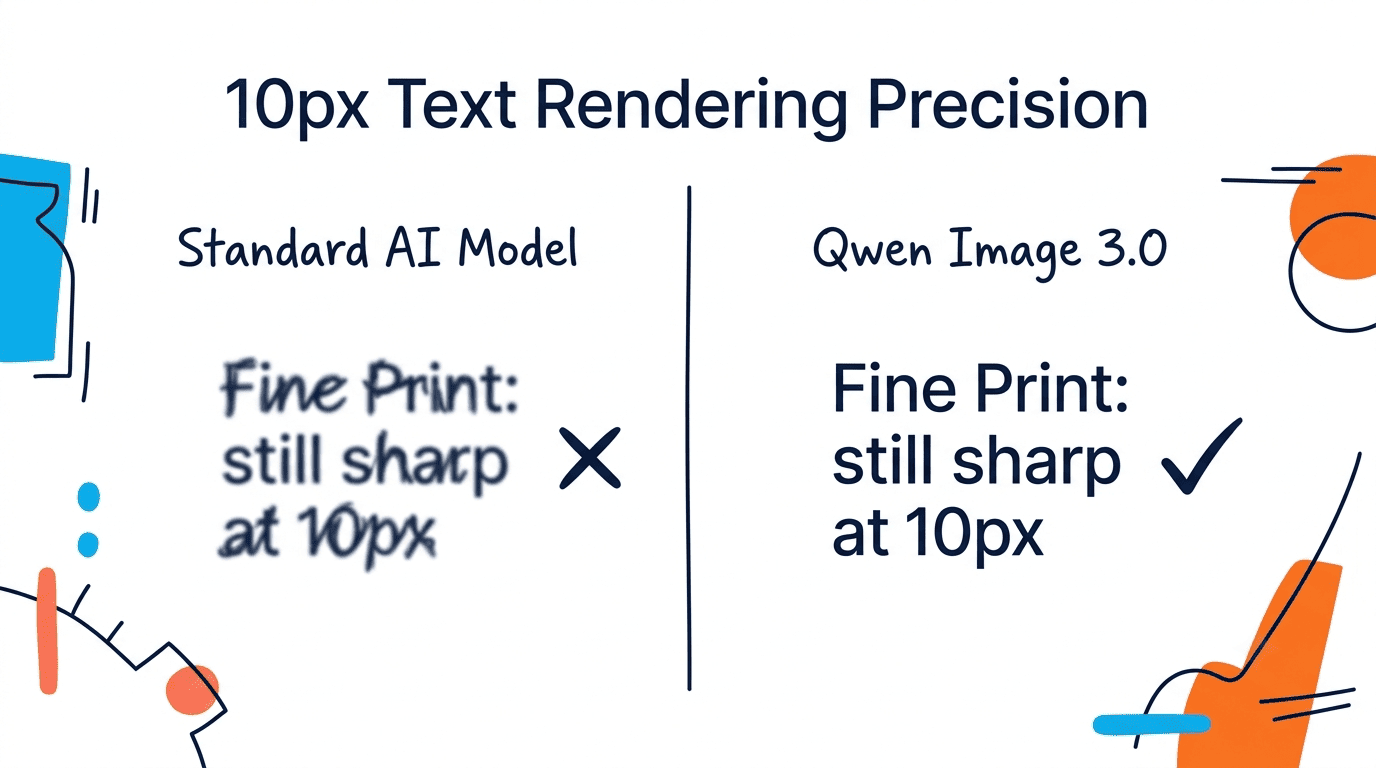
Qwen-Image-3.0 non si limita a perseguire il “bell’aspetto” — persegue l'”utilità”, rendendo la generazione di immagini un vero strumento di produttività realmente impiegabile.Team Qwen, annuncio QwenCloud, luglio 2026
Fedeltà visiva a livello micro
Oltre alla tipografia, Qwen Image 3.0 riproduce i dettagli fisici minuti con una precisione fotografica. Il modello cattura i pori individuali della pelle, i singoli capelli anziché masse sfumate, e micro-espressioni che trasmettono stati emotivi precisi. Qwen-Image-2512 (dicembre 2025) aveva stabilito questo livello di fedeltà specificamente per la ritrattistica umana; la versione 3.0 lo estende a una gamma di soggetti molto più ampia — fotografia di alimenti, texture di materiali, superfici di prodotti e dettagli ambientali.
Il team Qwen descrive il livello qualitativo come “vicino alla fotografia reale” — un’affermazione supportata dal posizionamento #1 di Qwen-Image-2512 tra i modelli open-source su AI Arena dopo oltre 10.000 cicli di valutazione cieca.
Conoscenza profonda: 12 lingue, interfacce realistiche e accesso al web
La tipografia multilingue nativa è il punto in cui Qwen Image 3.0 traccia la linea competitiva più netta. Il modello riproduce il testo in 12 lingue con oltre 20 varianti di carattere, mantenendo le convenzioni tipografiche appropriate a ciascun sistema di scrittura — inclusi script da destra a sinistra, caratteri logografici (cinese, giapponese, coreano) e lingue con diacritici complessi. Non si tratta di traslitterazione o sovrapposizione in post-elaborazione; il testo viene compreso semanticamente e riprodotto con le lettere contestualmente corrette per ogni scrittura.
La conseguenza pratica: i team internazionali possono generare materiali di marketing multilingue, screenshot localizzati di interfacce ed etichette di prodotto multilingue senza cambiare strumento o dover correggere manualmente gli output per ciascuna versione linguistica. Un singolo prompt che specifica la lingua di destinazione e il testo viene reso correttamente per ogni scrittura supportata.
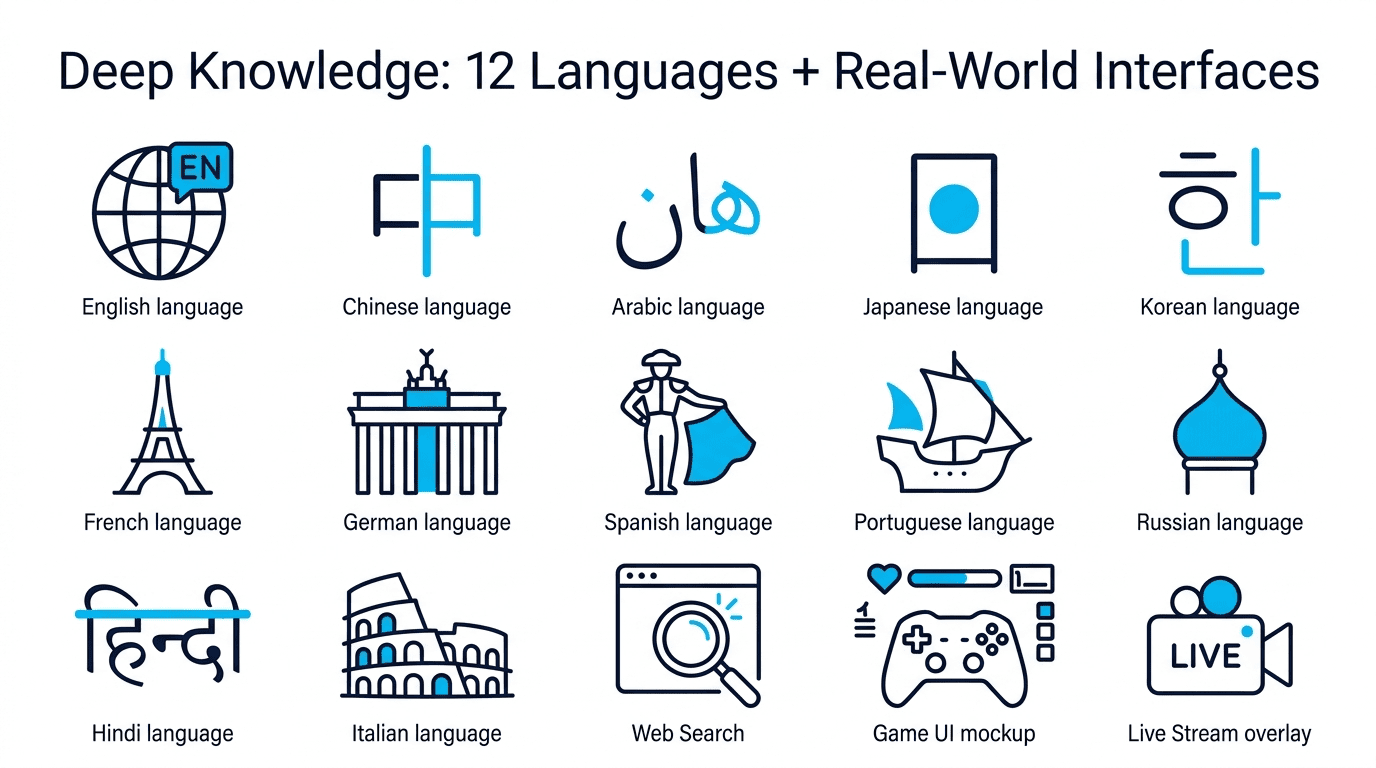
Simulazione realistica di interfacce
Il modello AI di Alibaba genera mockup accurati di pagine web, applicazioni mobile, interfacce di gioco e overlay per live streaming — completi di elementi grafici specifici della piattaforma, pattern di navigazione e componenti di interazione. Un mockup di pagina web include barre degli indirizzi realistiche, indicatori di scorrimento e stile dei link. Uno screenshot di app mobile rispetta le convenzioni di design a livello di sistema operativo per iOS o Android. Un’interfaccia di gioco riproduce gli elementi HUD in layout adeguati al genere.
Ciò rende Qwen Image 3.0 direttamente applicabile a:
- Prototipazione UX/UI prima che venga scritto qualsiasi codice
- Generazione di screenshot per gli store di app nei listing di prodotto
- Concept art per interfacce di gioco e revisioni di direzione creativa
- Design di layout per live streaming e mockup di overlay
Generazione con accesso al web
Qwen Image 3.0 integra una funzionalità di Ricerca Web che gli consente di incorporare dati in tempo reale nelle immagini generate. L’esempio tratto dall’annuncio di Alibaba: richiedere una grafica di previsioni meteo per una città e una data specifiche restituisce un’infografica accurata — non un’approssimazione — perché il modello recupera le condizioni attuali prima di generare la visualizzazione. Questo è architetturalmente diverso dai modelli puramente generativi, che possono solo estrapolare dai dati di addestramento.
Per le applicazioni pratiche, ciò significa che le infografiche generate possono riflettere statistiche attuali, dati di mercato in tempo reale o informazioni specifiche di un evento senza che l’utente debba fornire manualmente i dati nel prompt.
Come accedere a Qwen Image 3.0
Esistono due modalità per utilizzare Qwen Image 3.0: un’interfaccia browser no-code e un’API per sviluppatori. Entrambe operano attualmente in anteprima su invito, il che significa che l’accesso non è ancora universalmente disponibile.
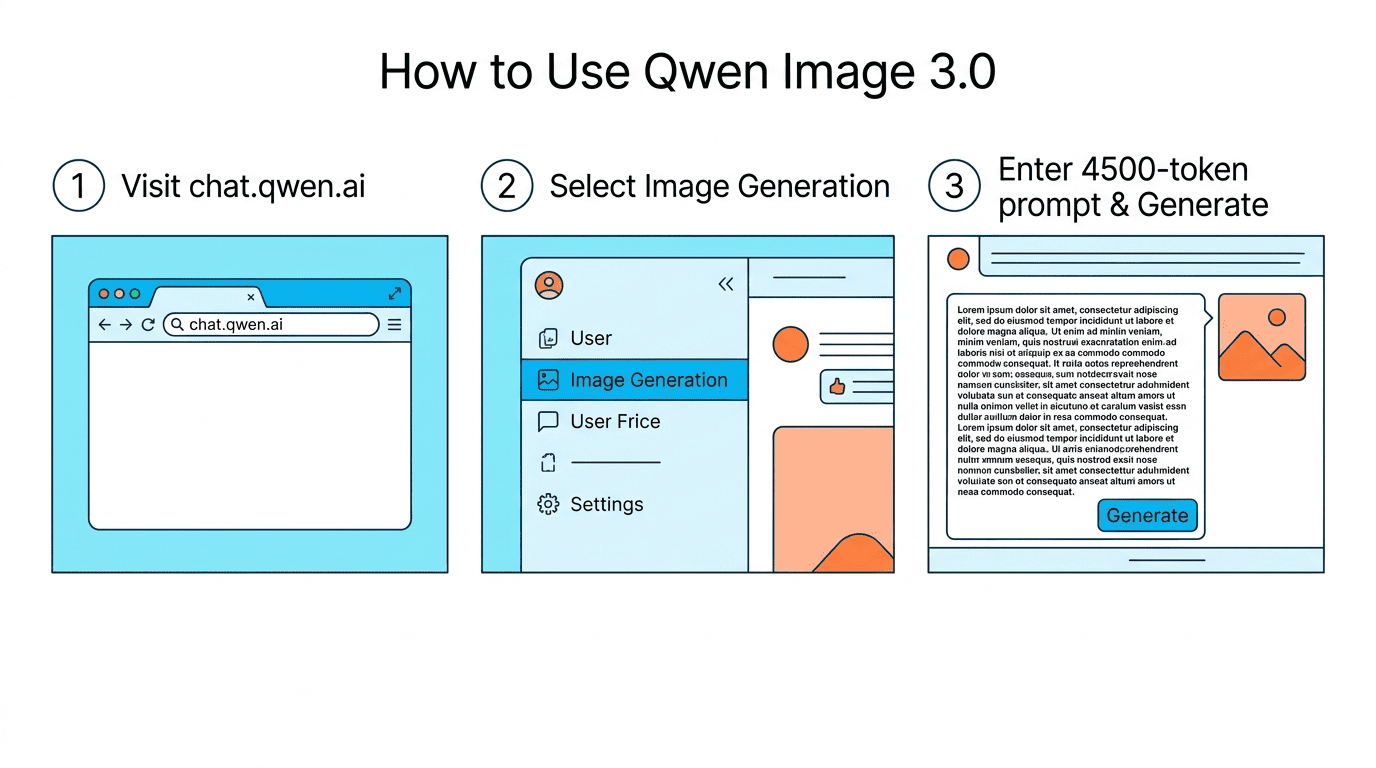
Tramite chat.qwen.ai (no-code)
Il percorso più semplice è chat.qwen.ai. Dopo aver effettuato l’accesso con un account Qwen, selezionare “Image Generation” e inserire un prompt. Il limite completo di 4.500 token si applica anche qui — l’interfaccia chat supporta prompt strutturati dettagliati senza troncamento. Per questa modalità non sono necessarie credenziali API.
Tramite l’API QwenCloud / DashScope (sviluppatori)
Per la generazione programmatica, i dettagli dell’API sono i seguenti:
| Parametro | Valore |
|---|---|
| ID modello | qwen-image-3.0-pro |
| Endpoint API | https://dashscope-intl.aliyuncs.com/api/v1/services/aigc/multimodal-generation/generation |
| Autenticazione | Bearer token (chiave API da home.qwencloud.com/api-keys) |
| Limite di frequenza | 1 RPM (livello di anteprima su invito) |
| Documentazione | docs.qwencloud.com |
Ecco il flusso minimo per effettuare una richiesta di generazione tramite l’API DashScope:
- Creare un account QwenCloud su home.qwencloud.com.
- Generare una chiave API dalla sezione Chiavi API della propria dashboard.
- Inviare una richiesta POST all’endpoint di generazione con
model: "qwen-image-3.0-pro"e il proprio prompt nell’array messages. - Ricevere un ID attività nella risposta — la generazione è asincrona.
- Interrogare l’endpoint di stato dell’attività usando l’ID attività fino a quando lo stato non cambia in
SUCCEEDED. - Recuperare l’URL dell’immagine generata dal risultato dell’attività e scaricarla o incorporarla.
- Verificare i limiti di frequenza — durante l’anteprima su invito, il limite è di 1 richiesta al minuto.
Funzionalità API enterprise
Il modello qwen-image-3.0-pro supporta diverse funzionalità di integrazione avanzate che vanno oltre la generazione di base:
- Function Calling — collega il modello di immagini a fonti di dati esterne e strumenti al momento della generazione
- Context Cache — memorizza i prefissi condivisi del prompt per ridurre latenza e calcolo nei flussi di lavoro batch a lungo contesto
- Structured Outputs — restituisce metadati in formato JSON insieme alle immagini generate per l’elaborazione programmatica a valle
- Fine-tuning — personalizza il modello base su stili visivi specifici del dominio, linee guida del brand o sistemi di design proprietari
- Batch processing — invia più richieste di generazione in parallelo entro i limiti di frequenza dell’API
Qwen Image 3.0 vs. versioni precedenti e concorrenti
Confronto tra versioni: 3.0 vs. 2.0
Il percorso di aggiornamento diretto da Qwen-Image-2.0 (febbraio 2026) mostra differenze misurabili in ogni capacità fondamentale:
| Capacità | Qwen-Image-2.0 | Qwen-Image-3.0 |
|---|---|---|
| Lunghezza massima del prompt | 1.000 token | 4.500 token |
| Precisione della resa del testo | Elevata | Fino a 10px |
| Supporto linguistico | Multilingue | 12 lingue nativamente |
| Varianti di carattere | Non specificato | 20+ |
| Pesi aperti | No | No |
| Connesso al web | No | Sì |
| Benchmark pubblicati | Sì | Non rilasciati |
| ID modello API | Non specificato | qwen-image-3.0-pro |
La svolta verso il closed-source: cosa è cambiato dalla versione 1.0
Qwen-Image-1.0 (agosto 2025) è stato rilasciato con licenza open-source Apache 2.0 con pesi su HuggingFace e ModelScope, accompagnato da un report tecnico su arXiv (arXiv:2508.02324) che descriveva l’architettura MMDiT a 20B parametri. Su quella base sono state costruite versioni fine-tuned dalla community, distribuzioni locali e ricerche accademiche.
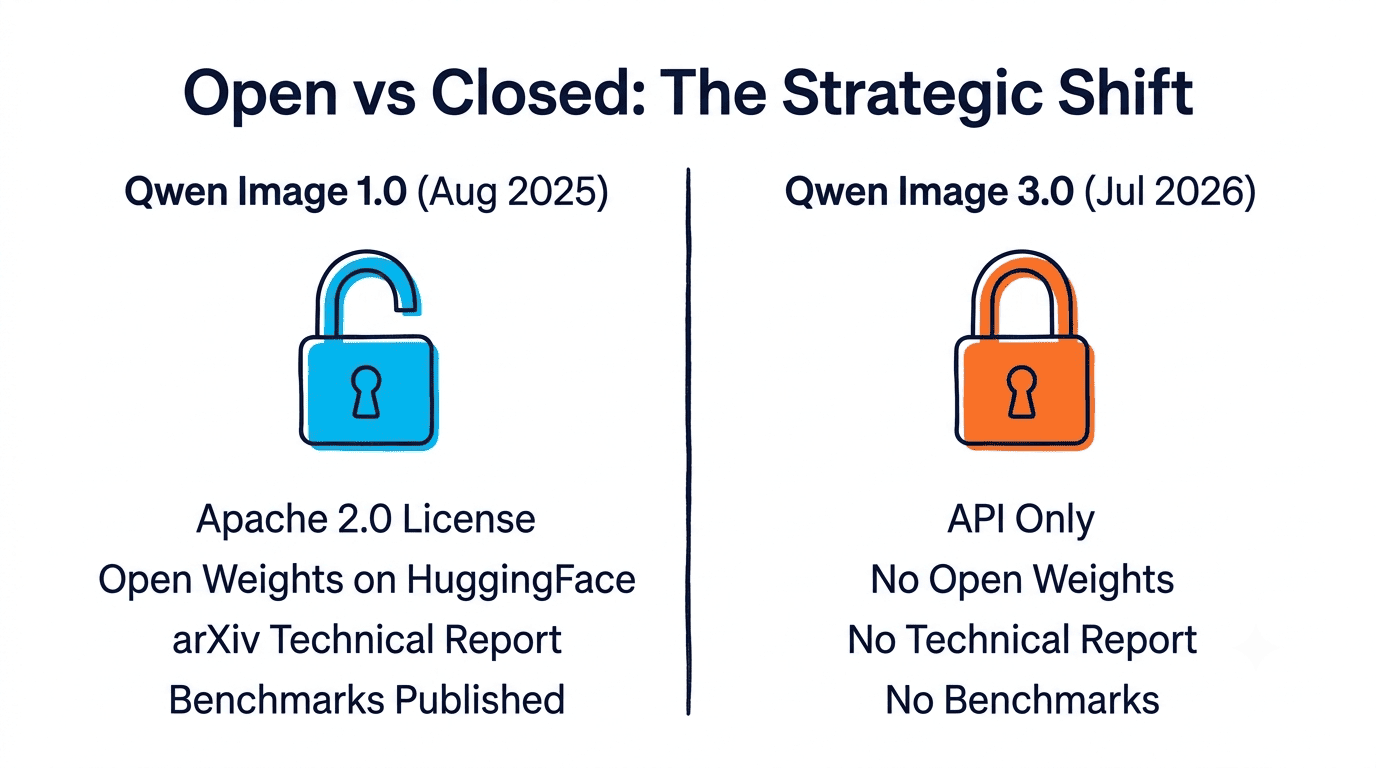
Qwen Image 3.0 viene distribuito come API chiusa senza pesi, senza report tecnico e senza divulgazione dell’architettura. Si tratta di uno spostamento strategico deliberato — dal modello di ricerca aperto al prodotto di distribuzione commerciale. L’implicazione per gli sviluppatori: le versioni fine-tuned della community e le varianti self-hosted rimangono sui pesi della versione 1.0, non della 3.0. Il team Qwen non ha indicato alcun piano per rilasciare i pesi della versione 3.0.
Posizionamento rispetto a Midjourney e DALL-E
Non sono stati pubblicati benchmark ufficiali che confrontino Qwen Image 3.0 con i modelli concorrenti. Sulla base delle capacità dichiarate, la differenziazione si articola come segue:
- vs. Midjourney: Qwen-Image-3.0 è più forte per la generazione di documenti e infografiche con prompt strutturati da 4.500 token; Midjourney è superiore per output artistici e stilistici
- vs. DALL-E 3: Resa nativa esplicita in 12 lingue rispetto all’approccio English-first di DALL-E; recupero con accesso al web di Qwen rispetto ai dati di addestramento statici di DALL-E
- vs. Ideogram: Entrambi hanno un posizionamento incentrato sul testo, ma la maggiore capacità di prompt di Qwen consente output multi-pannello in singolo passaggio che Ideogram non può eguagliare con gli attuali limiti di prompt
Limitazioni di Qwen Image 3.0
Nessun peso aperto, nessun benchmark pubblicato e accesso limitato sono le tre limitazioni concrete da considerare quando si valuta Qwen Image 3.0 per un progetto.
La chiusura dell’architettura del modello significa che i ricercatori indipendenti non possono verificare le affermazioni sulle capacità, esaminare il modello per individuare distorsioni o riprodurre i risultati al di fuori dell’API. L’assenza di benchmark rispetto a set di valutazione standard — T2I-CompBench, DrawBench, GenEval — rende la valutazione comparativa della qualità interamente dipendente da test empirici di terze parti anziché da metriche fornite dal produttore.
Il limite di 1 RPM durante l’anteprima su invito è un vincolo pratico per qualsiasi flusso di lavoro di generazione batch. A una richiesta al minuto, generare 100 immagini richiede circa 100 minuti anche con latenza di generazione zero — adatto per la prototipazione a basso volume, ma non per la scala produttiva. Le tempistiche di disponibilità completa e i prezzi non sono stati comunicati.
Gli utenti della community che hanno costruito flussi di lavoro sui pesi di Qwen-Image-1.0 (tramite HuggingFace o ModelScope) devono tenere presente che la versione 3.0 non è un sostituto drop-in in alcuna configurazione self-hosted. La progressione dalla versione open a quella closed è tanto architetturale quanto commerciale.