
Qwen 3.8 Max: Il Flagship da 2,4 Trilioni di Parametri di Alibaba Spiegato (Specifiche, Benchmark, Prezzi e Accesso)
Qwen 3.8 Max è il più recente modello linguistico di grandi dimensioni di punta di Alibaba, presentato in anteprima il 19 luglio 2026 alla World AI Conference (WAIC) di Shanghai con l’identificativo qwen3.8-max-preview. La sua caratteristica distintiva è un’architettura sparse Mixture-of-Experts da 2,4 trilioni di parametri. È stato lanciato con quasi nessun benchmark pubblicato, quindi questa guida separa i pochi fatti confermati — parametri, prezzi e canali di accesso — dall’affermazione di marketing di Alibaba secondo cui il modello è “secondo solo a Claude Fable 5“, che rimane non verificata in assenza di una tabella di benchmark ufficiale o di una scheda modello.
Cos’è Qwen 3.8 Max?
Un nuovo flagship nella famiglia Qwen
Qwen3.8-Max è il livello “Max” di punta della famiglia di modelli AI Qwen di Alibaba, presentato alla WAIC di Shanghai il 19 luglio 2026 come build di anteprima. Succede a Qwen 3.7 Max (maggio 2026) ed è il primo modello di classe Max di Alibaba superiore a un trilione di parametri ad accettare input multimodale, secondo lo sviluppatore Shuai Bai. Il modello si trova al vertice di una gamma che include anche un fratello minore, Qwen3.8-27B, annunciato nello stesso evento.
Il nome deriva dalla convenzione di denominazione a livelli di Alibaba: “Max” indica la variante con le prestazioni più elevate in ciascuna generazione Qwen, non un conteggio grezzo dei parametri. Per contesto, la linea Qwen è stata monitorata sull’articolo Wikipedia dedicato a Qwen come una delle famiglie di modelli open cinesi più attivamente sviluppate.
Non è lo stesso di Qwen3-8B
Una trappola di denominazione comune: “Qwen 3.8 Max” (un flagship da circa 2,4 trilioni di parametri) è completamente diverso dal più vecchio “Qwen3-8B” denso, che ha circa 8 miliardi di parametri. I lettori che cercano un numero di versione spesso confondono i due. Il “3.8” in Qwen 3.8 Max si riferisce alla versione della generazione, non al conteggio dei parametri, mentre “Qwen3-8B” ha letteralmente 8 miliardi di pesi.
Specifiche di Qwen 3.8 Max: Parametri, Architettura, Contesto e Modalità
I numeri confermati
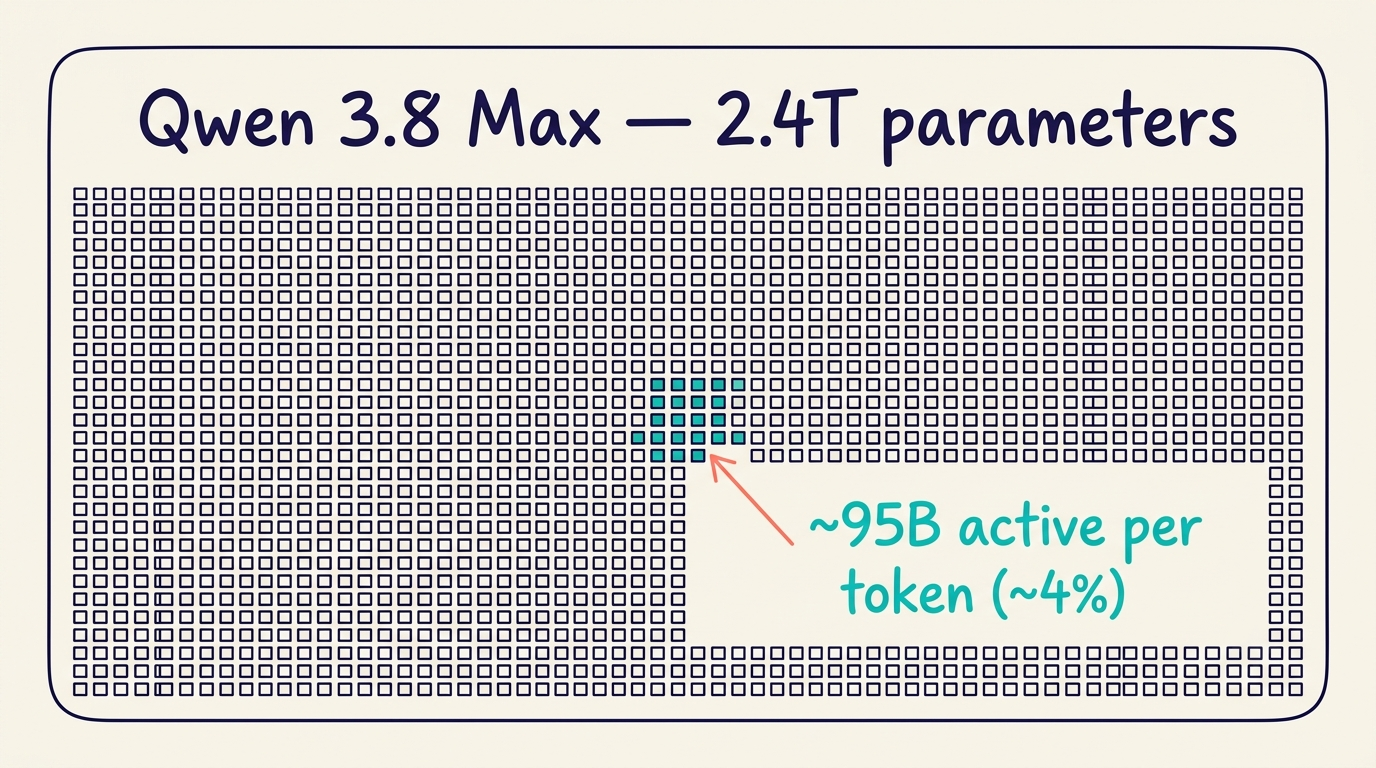
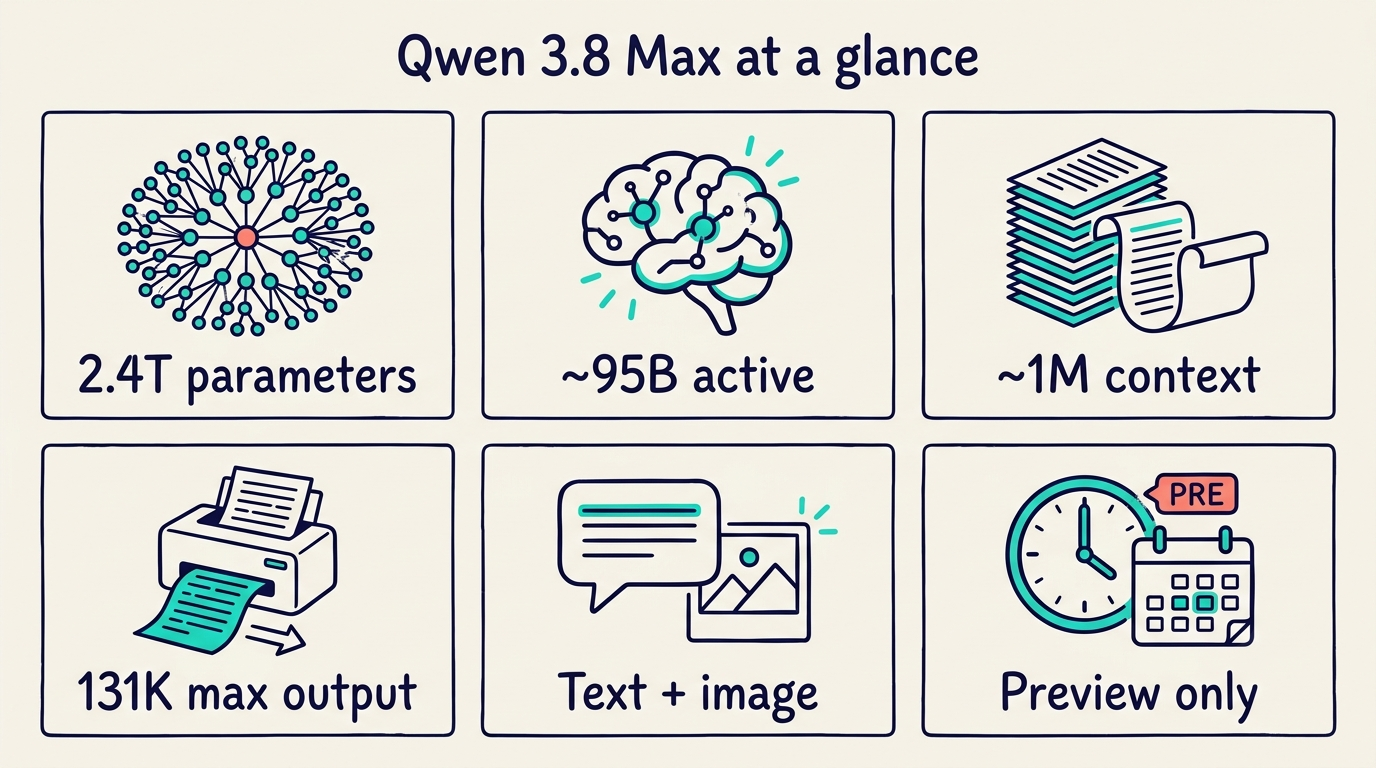
2,4 trilioni di parametri totali è l’unica specifica fermamente confermata, usando un’architettura sparse Mixture-of-Experts (MoE) che attiva solo circa 95 miliardi di parametri — circa il 4% — per token. Questa efficienza di attivazione è fondamentale per come il modello può funzionare su scala di inferenza senza richiedere che ogni parametro si attivi su ogni richiesta.
| Specifica | Valore | Affidabilità della fonte |
|---|---|---|
| Parametri totali | 2,4 trilioni | Confermato |
| Attivi per token | ~95 miliardi (~4%) | Confermato |
| Finestra di contesto | 983.616 token (metadati Qwen Cloud); “fino a 1M” (arrotondato nella copertura stampa) | Riportato |
| Output massimo | 131.072 token | Riportato |
| Modalità | Testo + immagine (video/doc/voce riportati) | Parzialmente confermato |
| Livello di ragionamento | Low / high / xhigh (default xhigh) | Riportato |
| Temperatura | 0,6 | Riportato |
| Tool call parallele | Non supportate (anteprima) | Confermato |
Il dato sulla finestra di contesto merita un’attenzione particolare: i metadati di Qwen Cloud indicano 983.616 token, ma Alibaba e diversi giornalisti arrotondano questo valore a “fino a 1M”. Entrambe le cifre fanno riferimento alla stessa architettura; il limite preciso dipende da come si accede al modello.
Cosa significa “multimodale” in questo contesto
L’input di testo e immagine è confermato in pratica. Alibaba e la copertura iniziale menzionano anche la comprensione video, l’analisi di documenti, la gestione della voce e la generazione di immagini — ma non esiste una scheda tecnica formale che confermi l’elenco completo delle modalità. Gli utilizzi dimostrati durante l’anteprima includevano la conversione di screenshot in app web funzionanti e la trasformazione di planimetrie architettoniche 2D in visualizzazioni 3D, entrambi basati su ragionamento immagine più testo.
Ragionamento e utilizzo degli strumenti
Il ragionamento nel flagship da 2,4T di Alibaba è sempre attivo — non è possibile disattivarlo, ma solo regolare il livello di sforzo tra low, high e xhigh, con xhigh impostato come default. Questa è una scelta progettuale che sacrifica la velocità a favore dell’affidabilità su compiti complessi. Il modello espone endpoint API compatibili sia con OpenAI che con Anthropic, il che significa che gli SDK esistenti possono utilizzarlo semplicemente cambiando l’URL di base. La limitazione significativa dell’anteprima è che le tool call parallele non sono ancora supportate, il che esclude alcune pipeline agentiche a più fasi.
Secondo il responsabile del team Qwen Shuai Bai, Qwen 3.8 Max è il primo modello di classe Max della famiglia a superare il trilione di parametri accettando al contempo input multimodale nativo — un passo architetturale notevole, sebbene la conferma indipendente dell’elenco completo delle modalità sia ancora in attesa.
Benchmark di Qwen 3.8 Max: Affermazione del Vendor vs Realtà Indipendente
La dichiarazione del vendor
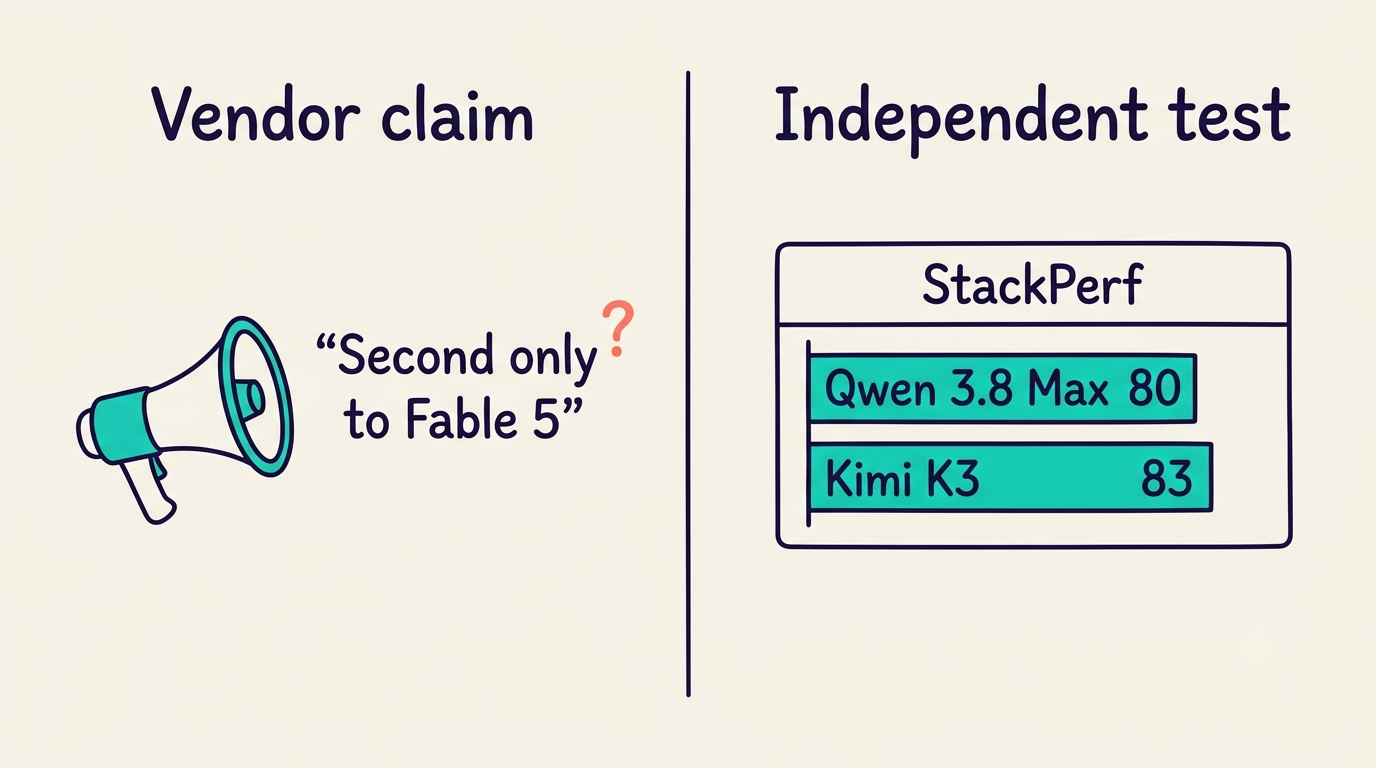
Alibaba ha posizionato Qwen3.8-Max come “secondo solo a Claude Fable 5” al lancio — ma non ha pubblicato nessuna tabella di benchmark, scheda modello o documento di licenza a corredo. Quella formulazione dovrebbe essere letta come una posizione di marketing non verificata. I primi segnali dell’arena lo collocano al 5° posto nella LMSYS Text Arena e al 2° posto nella Vision Arena — queste classifiche sono auto-dichiarate e potrebbero cambiare man mano che si accumulano più voti, ma suggeriscono una forte comprensione delle immagini rispetto alla posizione nella classifica solo testo.
I numeri di confronto diretto che esistono
Vale la pena esaminare i primi confronti diretti riportati, con la precisazione che provengono da coperture di terze parti piuttosto che dalla documentazione ufficiale di Alibaba:
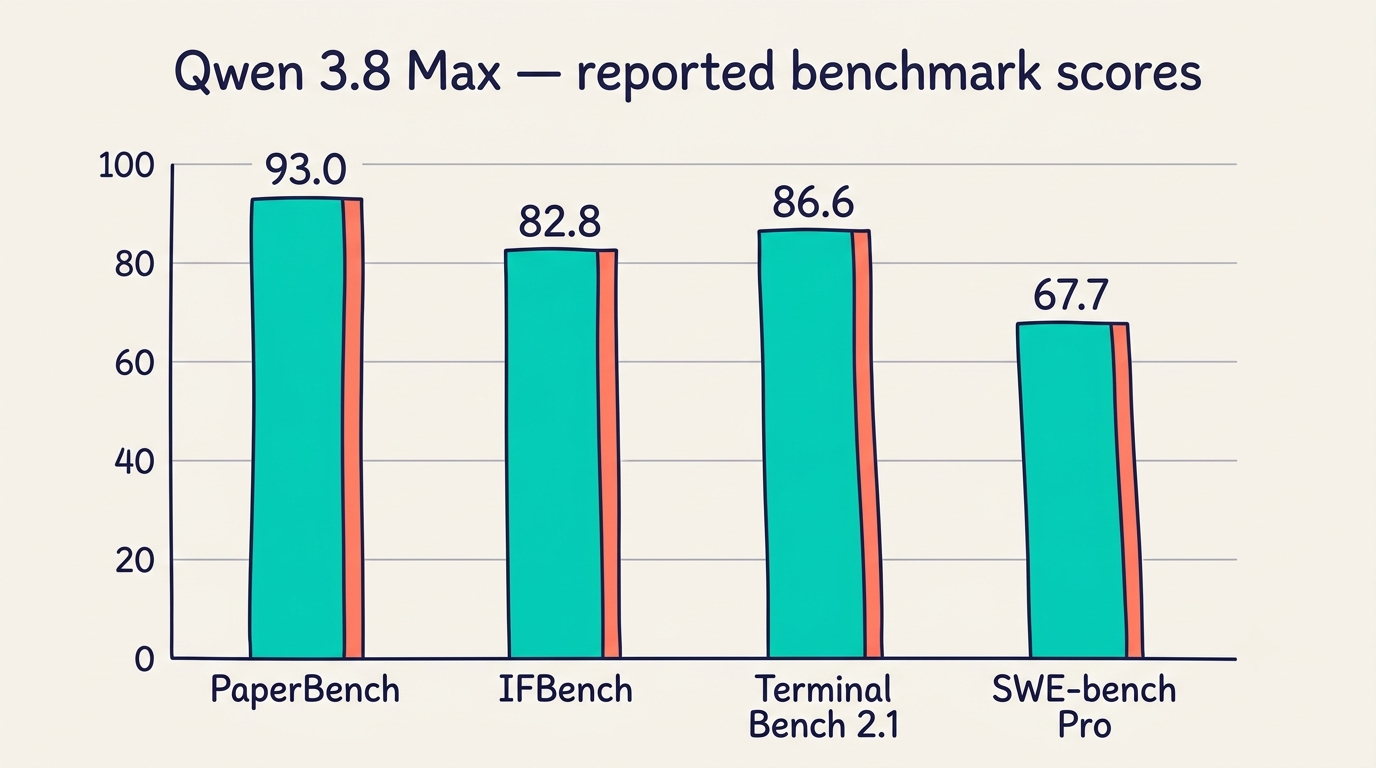
| Benchmark | Qwen 3.8 Max | GPT-5.6 Sol | Claude Fable 5 | Vincitore |
|---|---|---|---|---|
| PaperBench | 93,0 | 90,5 | — | Qwen |
| IFBench | 82,8 | 72,7 | — | Qwen |
| Terminal Bench 2.1 | 86,6 | 88,8 | — | GPT-5.6 Sol |
| MRCR v2 | 92,9 | 93,8 | — | GPT-5.6 Sol |
| SWE-bench Pro | 67,7 | — | 80,0 | Fable 5 |
| Humanity’s Last Exam | 43,6 | — | 53,3 | Fable 5 |
Il pattern è chiaro: il flagship da 2,4T di Alibaba è genuinamente competitivo nei compiti di instruction-following e di ricerca, ma Claude Fable 5 mantiene un vantaggio sostanziale sull’ingegneria del software e sul ragionamento complesso. “Secondo solo a Fable 5” è plausibile in senso lato per alcune categorie e dimostrabilmente falso per altre.
L’unico test indipendente
Il punto dati neutrale più chiaro disponibile è il test StackPerf su 269 file con agente di codifica. Qwen 3.8 Max ha ottenuto 80/100 contro 83/100 di Kimi K3 — tre punti di distanza. Qwen ha effettuato 44 tool call durante il test senza alcun errore e ha raggiunto un’affidabilità di 9/10 nell’uso degli strumenti. Questo risultato posiziona qwen3.8-max-preview come competitivo, non dominante, nella categoria agente di codifica in cui il marketing di Alibaba è più forte.
Prezzi di Qwen 3.8 Max
Prezzi durante l’anteprima (Token Plan)
Durante il periodo di anteprima, l’accesso è basato su crediti tramite il Token Plan di Alibaba a circa il 10% delle tariffe standard. I livelli del piano sono:
- Lite — circa $6
- Standard — circa $18
- Pro — circa $68
Nelle ore non di punta (22:00–08:00 UTC+8) si applica uno sconto aggiuntivo, che Alibaba sembra utilizzare come strumento di gestione della capacità durante le finestre di anteprima ad alta domanda. A partire dall’agosto 2026 non è stato pubblicato nessun prezzo ufficiale per token standalone via API.
Tariffa API riportata e confronto
Una tariffa API QwenCloud riportata è di $2,00 per milione di token in input, $6,00 per milione di token in output e $0,25 per milione di token in cache. Queste cifre devono essere trattate come riportate piuttosto che ufficialmente confermate finché Alibaba non pubblicherà una pagina ufficiale dei prezzi.
| Modello | Input ($/M) | Output ($/M) | Cache ($/M) | Stato |
|---|---|---|---|---|
| Qwen 3.8 Max | $2,00 | $6,00 | $0,25 | Riportato |
| Kimi K3 | $3,00 | $15,00 | — | Pubblicato |
| Qwen 3.7 Max | $1,25 | $3,75 | — | Pubblicato |
Se le tariffe riportate sono accurate, il nuovo flagship di Alibaba è sostanzialmente più conveniente di Kimi K3 sui token in output — dove i costi si accumulano nei carichi di lavoro a contesto lungo e agentici. Il predecessore Qwen 3.7 Max è più economico sull’input, ma il divario sull’output è notevolmente ampio.
Come Accedere a Qwen 3.8 Max
I canali disponibili oggi
Durante l’anteprima ci sono quattro percorsi principali per accedere al modello:
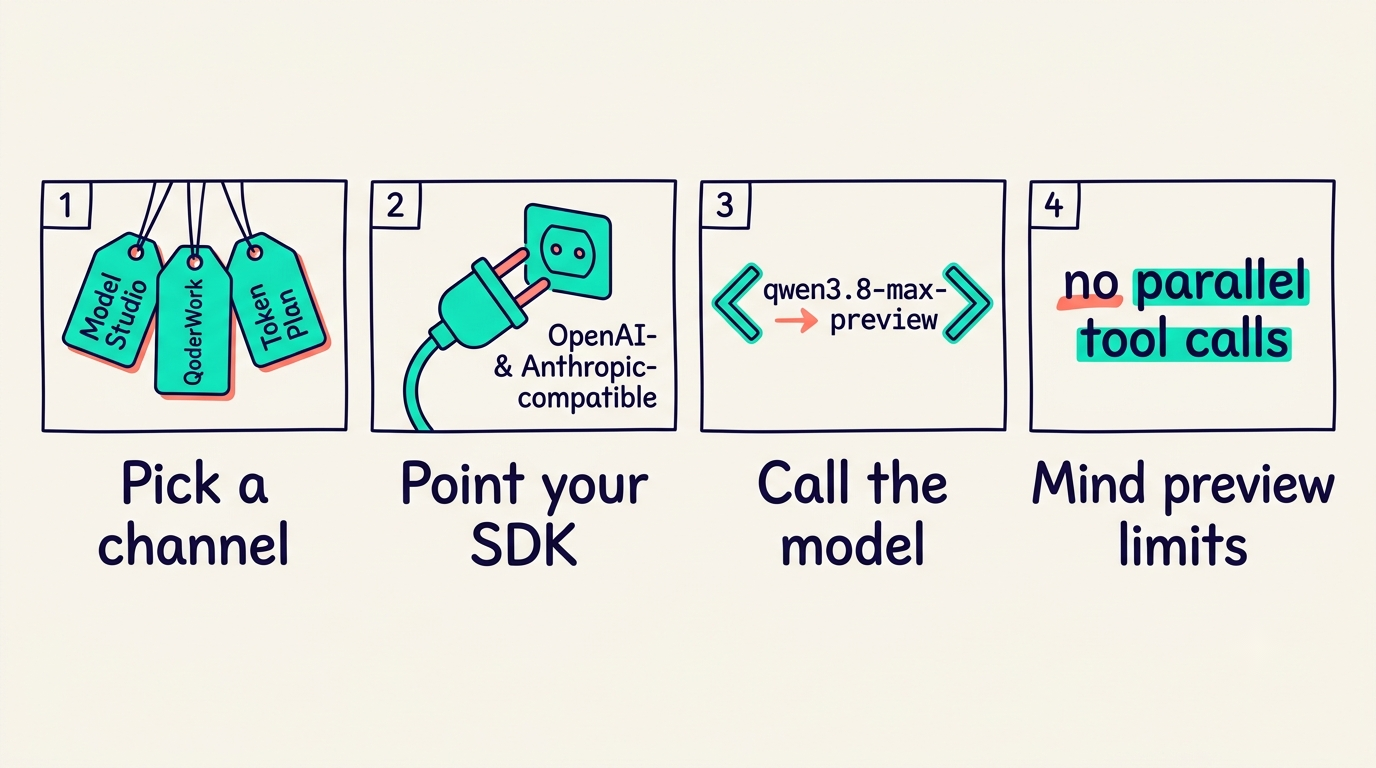
- Alibaba Cloud Model Studio — l’endpoint API principale; crea un account su Model Studio, genera una chiave API e punta il tuo SDK sul model ID
qwen3.8-max-preview. - QwenWork — uno spazio di lavoro in beta pubblica aperto lo stesso giorno del lancio dell’anteprima, pensato per l’utilizzo interattivo senza configurazione dell’SDK.
- Qoder e QoderWork — piattaforme focalizzate sul codice nell’ecosistema Qwen che espongono il modello con un’interfaccia per il completamento del codice e gli agenti.
- Token Plan — il sistema basato su crediti che regola l’accesso all’anteprima; gli account individuali si iscrivono qui prima di utilizzare uno qualsiasi dei canali sopra indicati.
Poiché gli endpoint sono compatibili sia con OpenAI che con Anthropic, strumenti come Cursor, Cline o qualsiasi SDK che punta a un URL base personalizzato possono passare al modello aggiornando una sola riga di configurazione. Il model ID da utilizzare è qwen3.8-max-preview.
Una nota sui limiti dell’anteprima
Il Token Plan individuale vieta esplicitamente l’utilizzo delle API backend e batch durante l’anteprima — quindi il modello è pensato per sessioni di codifica interattive e query di ricerca, non per pipeline di produzione. Le tool call parallele non sono ancora supportate, il che limita anche i flussi di lavoro agentici complessi a più passi. Se vuoi testare Qwen 3.8 Max a confronto con rivali come Claude Fable 5 e GPT-5.6 Sol senza collegare separatamente ciascuna API, le interfacce di chat multi-modello come bota.chat offrono un modo pratico per confrontare gli output affiancati.
Qwen 3.8 Max è Open Source? Stato dei Pesi Aperti
Promesso, ma non ancora consegnato
Alla data dell’annuncio del 3 agosto 2026, Alibaba afferma che i pesi aperti sono in arrivo “la settimana prossima” — senza una data precisa né una licenza allegata. Oggi qwen3.8-max-preview è disponibile solo tramite API e non è open source in nessun senso pratico. Se i pesi venissero rilasciati, sarebbe la prima volta che Alibaba mette a disposizione pesi aperti per un modello di classe Max. I precedenti rilasci della famiglia Qwen — tra cui Qwen3 e Qwen3-Coder — hanno utilizzato la licenza Apache 2.0, che consente l’uso commerciale e la modifica, quindi quella licenza è il precedente più probabile, anche se nulla è stato confermato.
Cosa richiederebbe eseguirlo localmente
Con 2,4 trilioni di parametri, i pesi sarebbero di circa 1,2 TB a quantizzazione a 4 bit e di circa 4,8 TB a 16 bit. Per avere un termine di paragone, una singola GPU H100 dispone di 80 GB di VRAM — quindi l’inferenza completa a 16 bit richiederebbe un cluster di circa 60 H100. Anche la quantizzazione a 4 bit richiede circa 15 H100. L’hosting autonomo è fuori dalla portata di quasi tutti gli sviluppatori e le organizzazioni, il che significa che l’accesso tramite API cloud rimarrà il percorso pratico anche dopo qualsiasi rilascio di pesi aperti.
I passaggi seguenti illustrano come verificare la disponibilità dei pesi una volta che saranno rilasciati:
- Tieni d’occhio l’organizzazione Qwen ufficiale su Hugging Face — è lì che Alibaba pubblica tutti gli artefatti del modello pubblici.
- Controlla il repository GitHub di Qwen per i dettagli sulla licenza e le guide alla quantizzazione.
- Una volta disponibili, utilizza
transformersovllmcon il flag di quantizzazione appropriato; 4 bit tramitebitsandbyteso formato GGUF tramitellama.cppsono i percorsi più accessibili. - Verifica il tuo budget hardware: prevedi almeno 1,2 TB di spazio su disco per il checkpoint a 4 bit più una quantità significativa di RAM durante il caricamento.
- Monitora le quantizzazioni della community su Hugging Face — le versioni INT4/GGUF di terze parti appaiono tipicamente entro pochi giorni da un rilascio ufficiale dei pesi e funzionano su hardware più piccolo.
Qwen 3.8 Max vs Kimi K3, GPT-5.6 Sol e GLM-5.2
Il campo competitivo
La frontiera del 2026 comprende ora diversi modelli in competizione nella stessa fascia di peso. Ecco dove si posiziona Qwen 3.8 Max rispetto ai suoi rivali più vicini:
| Modello | Sviluppatore | Parametri | Contesto | Pesi aperti | Prezzo riportato (input/output) |
|---|---|---|---|---|---|
| Qwen 3.8 Max | Alibaba | 2,4T MoE | ~1M | Promesso | $2 / $6 (riportato) |
| Kimi K3 | Moonshot AI | 2,8T MoE | 1M | Sì (27 luglio) | $3 / $15 |
| GLM-5.2 | Z.ai | ~753B / ~40B attivi | 1M | Sì (MIT) | — |
| GPT-5.6 Sol | OpenAI | Non divulgato | — | No | — |
| Claude Fable 5 | Anthropic | Non divulgato | — | No | — |
Kimi K3 di Moonshot AI è il rivale strutturalmente più simile: entrambi sono architetture MoE con finestre di contesto di circa 1M di token orientate ai compiti di codifica e agentici. Kimi K3 dispone già di pesi pubblicati e punteggi verificati indipendentemente, mentre Qwen 3.8 Max è ancora nella fase “fidatevi di noi”. GLM-5.2 di Z.ai è più piccolo ma viene distribuito con licenza MIT, rendendolo più permissivo per l’hosting commerciale autonomo rispetto a entrambi i modelli MoE più grandi.
Dove si inserisce Qwen 3.8 Max
Qwen 3.8 Max si colloca come un flagship cinese forte ma non ancora provato. Le affermazioni di marketing sono più grandi delle prove pubblicate; il comportamento nel codice e nell’uso degli strumenti è competitivo; i prezzi dell’anteprima sono aggressivi; e la promessa dei pesi aperti rimane vaga. Di fronte ai pesi già pubblicati di Kimi K3 e al suo punteggio StackPerf verificato di 83/100, i vantaggi concreti di Qwen sono un costo di output riportato più basso e una maggiore integrazione con l’ecosistema Alibaba Cloud per i team che già utilizzano quella infrastruttura.
Per gli sviluppatori che scelgono tra i due grandi modelli MoE cinesi in questo momento, Kimi K3 offre maggiore certezza — puoi scaricare e valutare i pesi oggi. Qwen 3.8 Max offre potenzialmente un costo API più basso e lo stack di supporto Alibaba, ma richiede di attendere sia il rilascio dei pesi aperti sia la conferma indipendente dei benchmark prima di prendere un impegno in produzione.