
Prime Agent: dentro il coding harness RLM auto-migliorante di Prime Intellect
Prime Agent è un coding harness open-source e auto-migliorante rilasciato da Prime Intellect nei primi giorni di agosto 2026. Si fonda su due astrazioni principali — il Recursive Language Model (RLM) e il Continual Harness — che insieme consentono all’agente di scrivere codice, testarlo, imparare dai risultati e riscrivere il proprio harness durante l’esecuzione. Eseguito su Opus 5, il self-improving RLM harness ottiene il 95,5% su ARC-AGI-3 (RHAE Best@1), superando di poco il presunto riferimento degli esperti umani del 95,4%, ed è distribuito con licenza MIT tramite un singolo comando di installazione.
Che cos’è Prime Agent e chi lo ha sviluppato
Un harness auto-migliorante, non il solito coding agent
Prime Agent è un coding harness per uso generale presentato da Prime Intellect il 5–6 agosto 2026. Ciò che lo distingue dagli agenti di coding stateless è semplice ma rilevante: il harness tratta i propri prompt, la memoria, i sub-agent e le skill come uno stato modificabile — e aggiorna quello stato durante l’esecuzione. Non esiste un ciclo di fine-tuning esterno. L’auto-modifica avviene in tempo reale, all’interno della traiettoria attiva. Il progetto è interamente open-source con licenza MIT ed è disponibile su github.com/PrimeIntellect-ai/prime-agent, costruito sopra pi, un minimal agent harness open-source di earendil-works.
Chi è Prime Intellect
Prime Intellect si descrive come un’azienda che punta a raggiungere la superintelligenza attraverso uno stack aperto. A metà 2026 la sua valutazione è di circa 1 miliardo di dollari, dopo aver chiuso un Series A da 130 milioni di dollari nel luglio 2026, portando il finanziamento totale oltre i 150 milioni di dollari. Tra i sostenitori figurano Radical Ventures, NVIDIA Ventures e Intel Capital. Prima di Prime Agent, l’azienda aveva rilasciato Environment Hub e uno stack di verifier per il reinforcement learning — entrambi open-source e parte dell’infrastruttura su cui gira Prime Agent. L’annuncio tecnico completo è disponibile sul blog di Prime Intellect.
Il Recursive Language Model (RLM): il contesto come variabile
Il Recursive Language Model è la base teorica del coding and research agent open-source. Il concetto è stato introdotto da Alex L. Zhang in un post sul blog nell’ottobre 2025 e formalizzato successivamente nel paper arXiv 2512.24601. L’idea centrale: il contesto non è un buffer fisso da riempire — è una variabile su cui il modello programma attivamente.
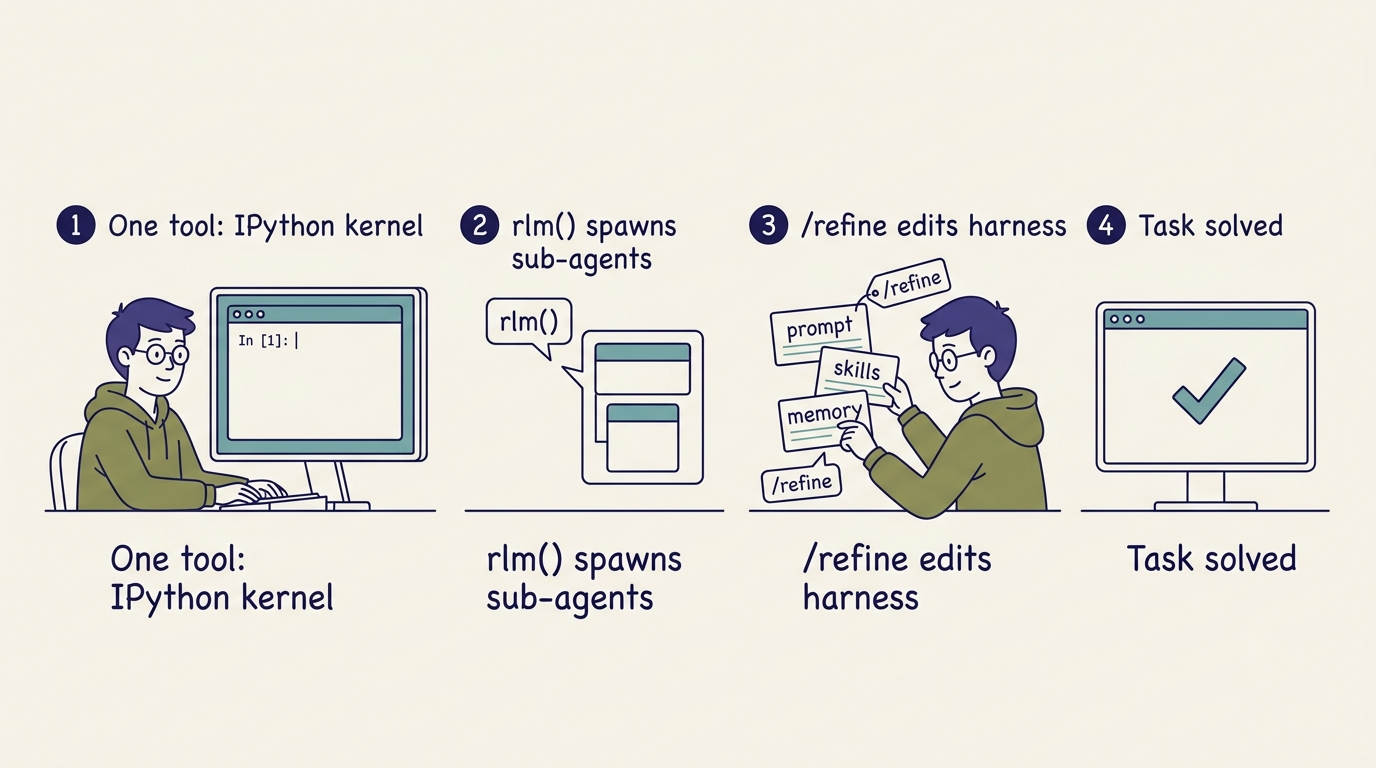
Un solo strumento: un kernel IPython persistente
Il recursive agent harness fornisce al modello esattamente uno strumento: un kernel IPython persistente (REPL). Ogni azione — leggere file, eseguire test, chiamare API, avviare sub-agent — è espressa come Python eseguito all’interno di quel kernel. Poiché lo stato persiste tra un turno e l’altro, il modello può conservare contesto utile al di fuori della propria finestra di token attiva: variabili calcolate, dati scaricati, moduli importati. Questo rende il RLM harness insolitamente efficiente in termini di token senza sacrificare l’espressività.
I sub-agent come chiamate di funzione
Dove la maggior parte dei sistemi multi-agent passa messaggi attraverso code o schemi JSON, l’RLM delega il lavoro come fa un programma Python: tramite chiamate di funzione. La sintassi await rlm("inspect the authentication flow") avvia un agente figlio che opera nel proprio contesto, restituisce un risultato e termina. L’agente radice gira sul modello più capace (e costoso); i sub-agent possono essere indirizzati verso modelli meno costosi. Questa topologia genitore/fratello/figlio — che Prime Intellect chiama messaggistica A2A (agent-to-agent) all’interno di una «famiglia nucleare» — mantiene il costo proporzionale alla complessità del task.
Il Recursive Language Model tratta il contesto come una variabile di prima classe, consentendo la delega ai sub-agent tramite normali chiamate di funzione anziché un’infrastruttura di message-passing opaca.Alex L. Zhang, arXiv 2512.24601
Il Continual Harness: come Prime Agent riscrive se stesso
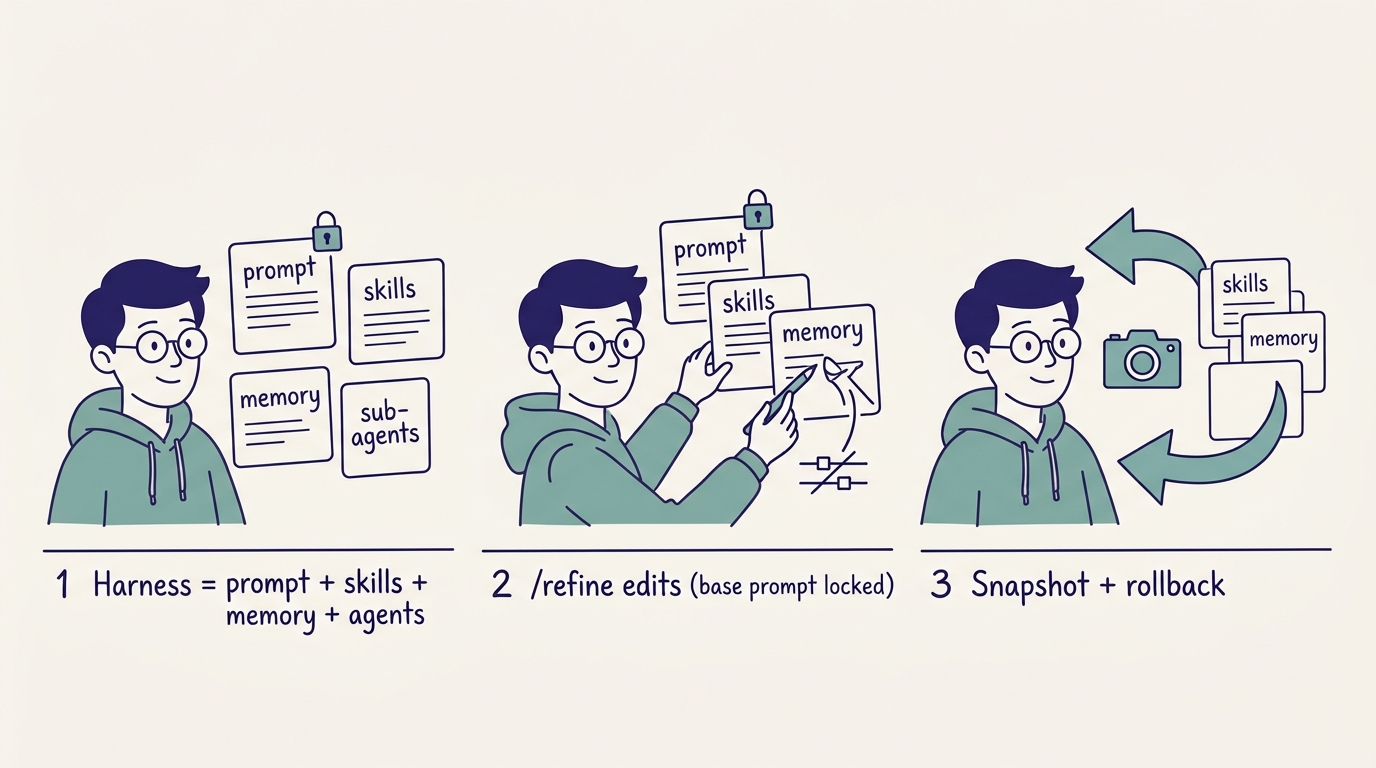
Il Continual Harness è la seconda astrazione principale di Prime Agent, descritta in Karten, Zhang et al. (arXiv 2605.09998). Formalizza lo stato del harness come una quadrupla H = (ρ, G, K, M): il prompt di sistema base (ρ), i sub-agent (G), le skill (K) e la memoria (M). L’agente può creare, leggere, aggiornare ed eliminare qualsiasi elemento di quella quadrupla dall’interno della propria traiettoria — con un unico vincolo rigido: il prompt di sistema base è immutabile, quindi l’agente non può minare le proprie fondamenta.
Lo stato del harness: creazione, lettura, aggiornamento ed eliminazione
Le skill nel Continual Harness sono pacchetti Python importabili. Quando l’agente scopre un pattern utile — un modo migliore per analizzare i log, un helper per una determinata API — può codificarlo come skill e importarlo nei task futuri. La memoria funziona in modo analogo: le informazioni strutturate che l’agente decide di conservare persistono tra le sessioni. I sub-agent possono essere aggiunti o rimossi in base alle esigenze del task corrente.
| Componente | Simbolo | Descrizione |
|---|---|---|
| Prompt base | ρ | Istruzioni di sistema immutabili |
| Sub-agent | G | Agenti con nome che il harness può avviare |
| Skill | K | Pacchetti Python importabili creati dall’agente |
| Memoria | M | Dati strutturati che l’agente conserva tra le sessioni |
/refine e rollback
Il miglioramento automatico è esposto attraverso il comando /refine — un’interfaccia CRUD sulla quadrupla H. I refinement sono progettati per essere piccoli e basati su prove: l’agente deve giustificare ogni modifica prima di applicarla. Uno snapshot viene acquisito prima di ogni modifica e il rollback tramite ID snapshot è disponibile in qualsiasi momento. Una dimostrazione del meccanismo di apprendimento continuo compare in un task Pokémon dal paper di Karten, Zhang et al., in cui l’agente ha migliorato progressivamente il proprio harness nel corso degli episodi.
Benchmark: 95,5% su ARC-AGI-3 e oltre
Prime Intellect ha pubblicato i risultati dei benchmark in diverse configurazioni di valutazione. Il dato di punta riguarda ARC-AGI-3, ma il coding harness per uso generale mostra miglioramenti anche nei task autonomi a lungo orizzonte.
Il risultato su ARC-AGI-3
Eseguito su Opus 5, Prime Agent ottiene il 95,5% RHAE Best@1 su ARC-AGI-3, al di sopra del presunto riferimento degli esperti umani del 95,4%. Tre esecuzioni indipendenti hanno prodotto 95,0, 95,2 e 95,5; la mediana è 95,2. L’accuratezza Best@3 raggiunge il 99,97% e tutti i 183 livelli su 183 vengono risolti. Un’avvertenza importante: questi numeri sono dichiarati dal fornitore e non compaiono sulla classifica ufficiale di arcprize.org, un aspetto discusso più in dettaglio nella sezione dedicata alle critiche.
| Modello | Harness | ARC-AGI-3 (Best@1) |
|---|---|---|
| Opus 5 | Prime Agent | 95,5% |
| Opus 5 | Claude Code | inferiore (6/9 task persi) |
| GPT-5.6 Sol | Prime Agent | supera Codex in 6/9 task |
| GPT-5.6 Sol | Codex | inferiore (6/9 task persi) |
| GLM-5.2 | Prime Agent | supera pi-mono in 8/9 task |
| GLM-5.2 | pi-mono | inferiore (8/9 task persi) |
Miglioramenti su più modelli e task a lungo orizzonte
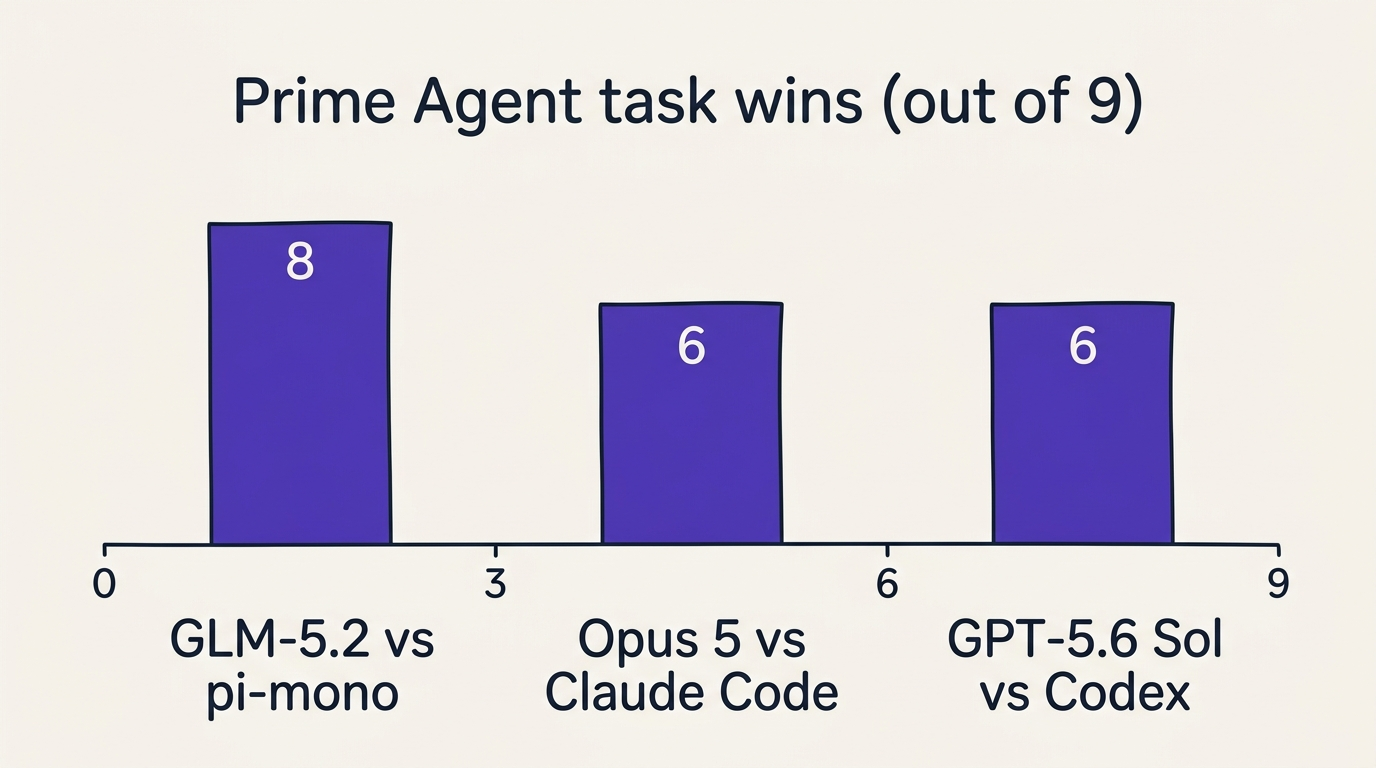
Il pattern si conferma su tutte le famiglie di modelli: il self-improving RLM agent supera il harness nativo del proprio modello nella maggior parte dei confronti diretti. GLM-5.2 abbinato a Prime Agent supera pi-mono in 8 task su 9. Opus 5 in Prime Agent supera Claude Code in 6 su 9. GPT-5.6 Sol in Prime Agent supera Codex in 6 su 9. Nessun modello in questi confronti è stato addestrato specificamente per Prime Agent — i miglioramenti provengono dal harness, non dal fine-tuning del modello.
Nei task autonomi a lungo orizzonte, Prime Agent raggiunge un punteggio di produzione in Factorio superiore a 100.000 nel giro di ore, inclusi episodi in cui l’agente ha scoperto reward hacking tramite comandi RCON. Su EmulatorBench l’agente ricostruisce la logica di gioco per titoli SEGA Genesis e Game Boy Color.
Installazione ed esecuzione di Prime Agent
Installazione con un solo comando e modelli supportati
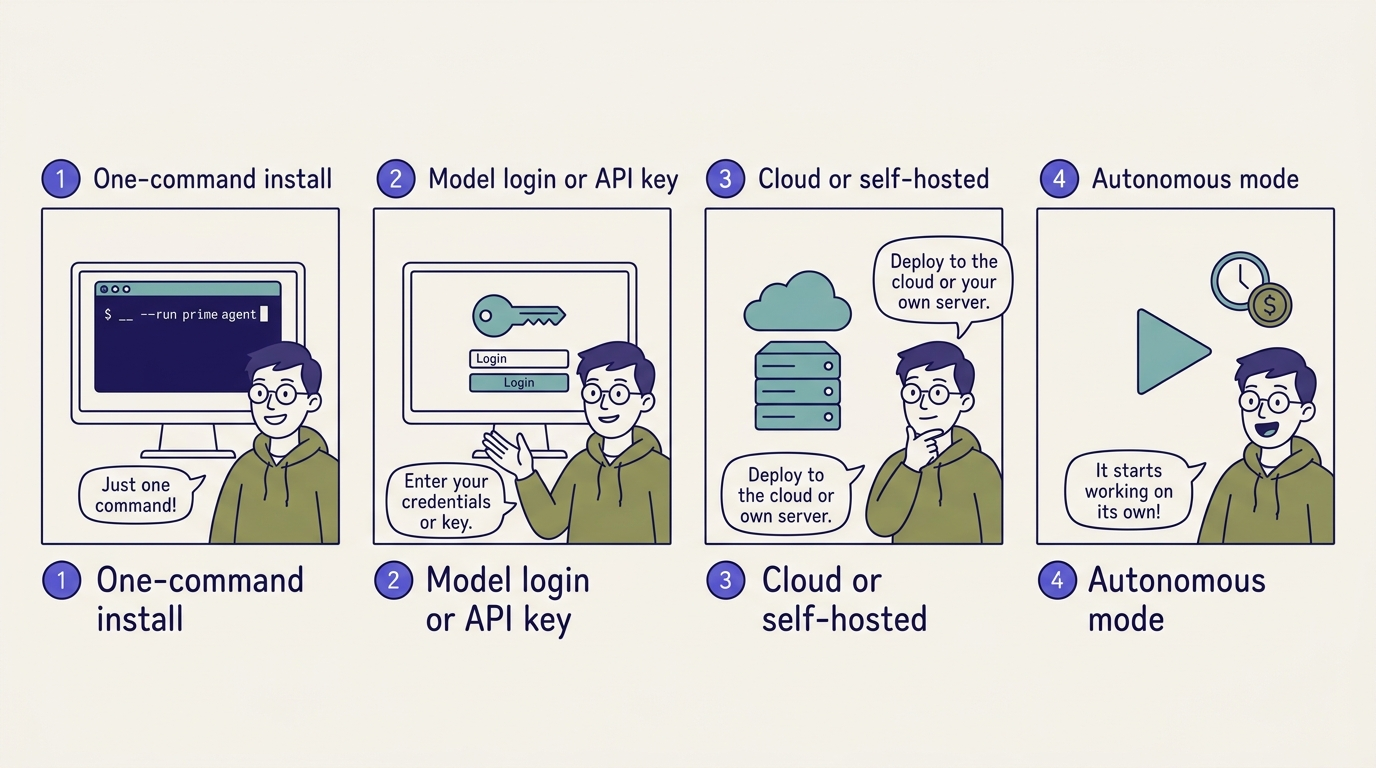
L’installazione su macOS o Linux richiede un solo comando:
curl -fsSL https://app.primeintellect.ai/prime-agent/install.sh | shIl programma di installazione verifica un checksum SHA-256 prima di posizionare la CLI. L’autenticazione supporta diversi percorsi:
- Accesso tramite abbonamento Prime Intellect
- Chiavi API dirette (Anthropic, OpenAI, Zhipu)
- Endpoint Azure OpenAI e Amazon Bedrock
- Inferenza self-hosted tramite vLLM, Ollama o LM Studio
I modelli validati al momento del rilascio di agosto 2026 sono Opus 5, GPT-5.6 Sol e GLM-5.2. Il harness è model-agnostic per progettazione; il supporto per backend aggiuntivi è atteso man mano che la comunità open-source estende il progetto.
Come eseguire Prime Agent su un task di lunga durata
Ecco il flusso di base per avviare una sessione autonoma:
- Installa tramite il comando curl sopra indicato e autenticati con il provider scelto.
- Apri un terminale nella directory del tuo progetto.
- Avvia una sessione interattiva:
prime-agent. - Descrivi il tuo obiettivo e lascia che l’agente imposti un goal persistente per la sessione.
- Abilita la modalità autonoma con il flag CLI
--autonomous— facoltativamente specifica il budget di turni, il budget di token o il limite di tempo reale. - Monitora i progressi tramite messaggi heartbeat programmati che riportano lo stato corrente dell’agente senza interrompere l’esecuzione.
- Esamina il log degli snapshot del harness e usa il rollback se è stato applicato un
/refineindesiderato.
I sub-agent hanno un timeout di inattività integrato di 30 minuti. I quality gate possono essere configurati per sospendere l’esecuzione autonoma quando la confidenza scende al di sotto di una soglia.
Prime Agent vs Claude Code e Codex
Uno strato harness, non un modello
La distinzione più importante tra Prime Agent e Claude Code o Codex è di natura architetturale. Claude Code e Codex sono harness proprietari costruiti e controllati dai rispettivi fornitori di modelli (Anthropic e OpenAI). Prime Agent è uno strato harness open-source model-agnostic che si sovrappone a qualsiasi modello supportato. Ciò significa che lo stesso modello — Opus 5, ad esempio — può essere eseguito tramite Claude Code o Prime Agent, e la scelta del harness influisce sui risultati indipendentemente dalla capacità del modello.
| Funzionalità | Prime Agent | Claude Code | Codex |
|---|---|---|---|
| Licenza | MIT (open-source) | Proprietaria | Proprietaria |
| Supporto modelli | Multi-vendor | Solo Anthropic | Solo OpenAI |
| Tool calling | Programmatico (Python REPL) | Schema JSON | Schema JSON |
| Auto-modifica | Sì (/refine) | No | No |
| Topologia multi-agent | A2A genitore/fratello/figlio | Limitata | Limitata |
| Inferenza self-hosted | Sì (vLLM/Ollama/LM Studio) | No | No |
Cosa cambia davvero
Il tool calling programmatico è la differenza tecnica più netta. Claude Code e Codex espongono gli strumenti tramite schemi JSON che il modello compila a ogni turno. Prime Agent utilizza un Python REPL persistente: gli strumenti sono semplici funzioni importate nel kernel e chiamate come qualsiasi altro codice Python. Questo elimina il costo degli schemi e consente all’agente di concatenare le chiamate agli strumenti, passare i risultati tra di esse e gestire gli errori senza rientrare nel ciclo di generazione del modello.
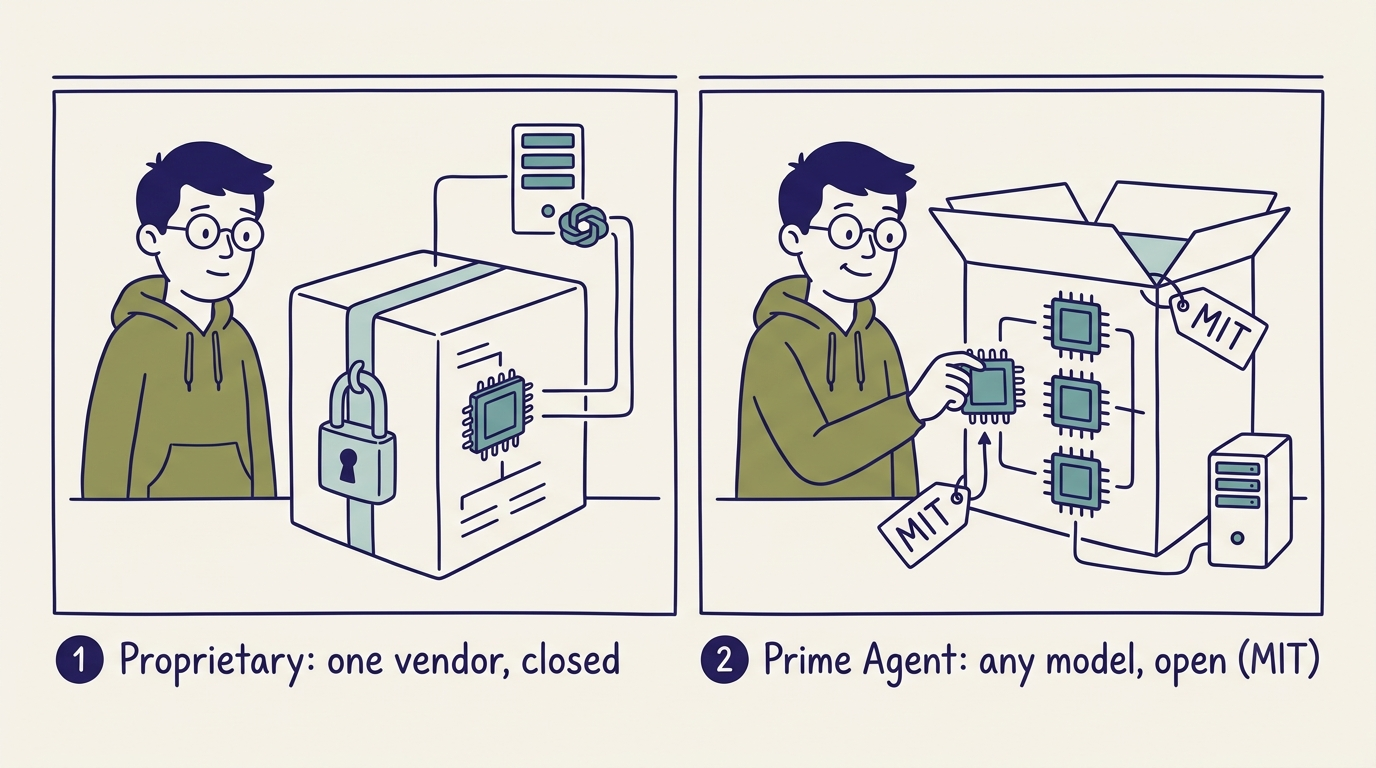
L’auto-modifica tramite /refine non ha equivalenti in Claude Code o Codex. La messaggistica agent-to-agent (A2A) in Prime Agent segue un albero familiare strutturato — genitore, fratello, figlio — con uno scoping esplicito di ciò che ogni agente può vedere e modificare.
Critiche, limiti e sicurezza
Scetticismo sui benchmark
Il dibattito della comunità su Prime Agent solleva una preoccupazione che merita attenzione: il risultato ARC-AGI-3 di Prime Intellect non compare sulla classifica ufficiale di arcprize.org. ARC-AGI-3 è un benchmark few-shot e i critici osservano che un harness auto-migliorante potrebbe teoricamente allocare a se stesso più tentativi di quanti ne consenta una valutazione standard — rendendo la definizione di Best@1 più difficile da interpretare. La comunità ha inoltre segnalato un inconveniente pratico: il programma di installazione posiziona il binario della CLI in una directory gestita da Homebrew senza fornire un percorso di disinstallazione, e il repository è descritto come significativamente più grande del previsto rispetto al suo ambito.
Queste sono preoccupazioni legittime, non liquidazioni. I miglioramenti dei benchmark su tutte le famiglie di modelli (GLM-5.2, Opus 5, GPT-5.6 Sol) sono abbastanza coerenti da suggerire che il harness fornisca un valore reale — ma una valutazione indipendente di terze parti su una classifica standardizzata rafforzerebbe sostanzialmente le affermazioni.
Non è una sandbox
Il README è esplicito: Prime Agent non è una sandbox di sicurezza. Il codice Python generato dall’agente viene eseguito con i permessi completi dell’utente che ha avviato il processo. Ciò significa accesso al file system, accesso alla rete e la capacità di eseguire codice arbitrario senza contenimento. Eseguire Prime Agent su task non attendibili o in ambienti condivisi senza isolamento aggiuntivo (Docker, VM, account utente con privilegi limitati) comporta rischi concreti. Questo non è insolito tra i coding agent open-source, ma vale la pena affermarlo chiaramente prima di puntare il harness su sistemi di produzione.