
La finestra di contesto da 1 milione di token, spiegata
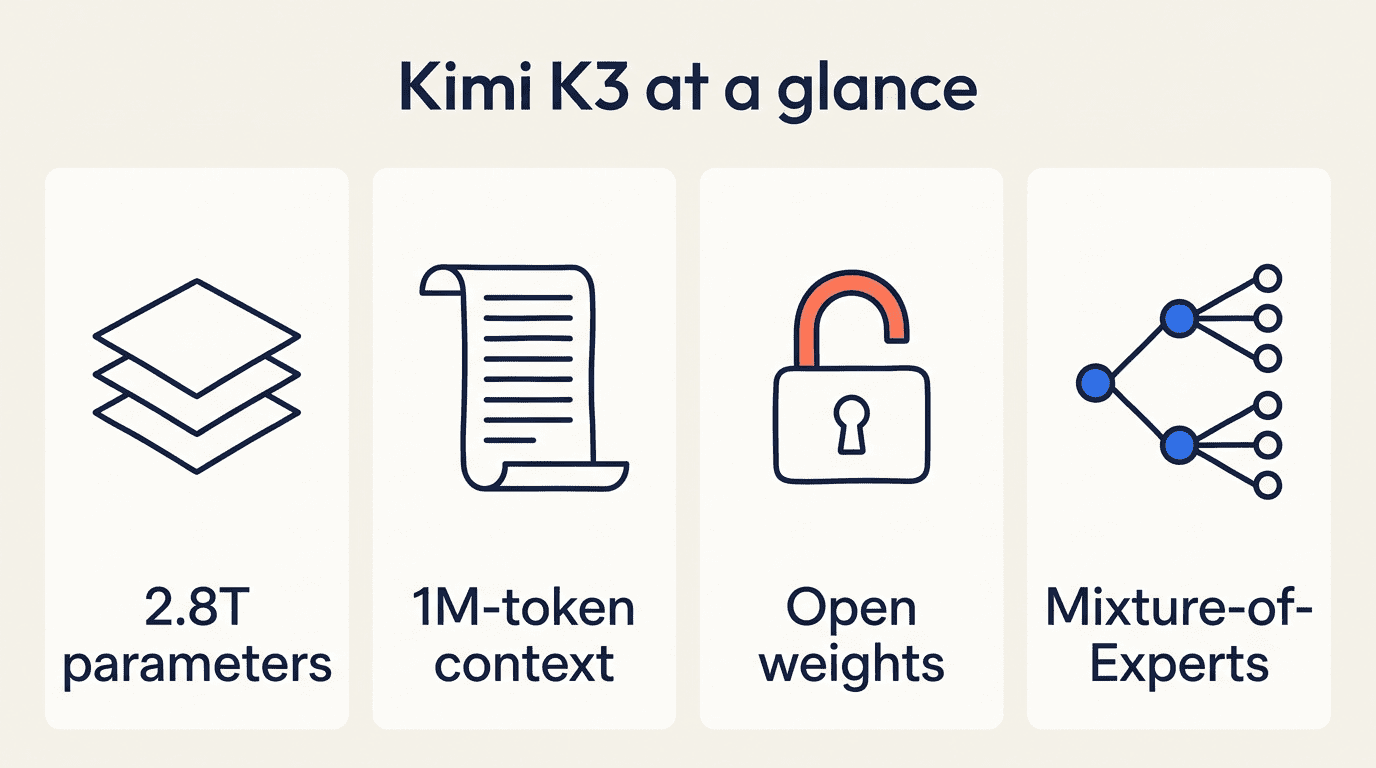
Una finestra di contesto da 1 milione di token è la quantità di testo che un grande modello linguistico può leggere ed elaborare in una singola richiesta. Secondo la pagina Wikipedia sui large language model, la lunghezza del contesto determina quanti prompt, cronologia e materiale di riferimento un modello può tenere in memoria contemporaneamente; 1 milione di token corrisponde a circa 750.000 parole. Una serie di modelli all’avanguardia viene ora distribuita con questa dimensione, tra cui Kimi K3 di Moonshot.
Questa guida spiega cos’è un token, cosa ci entra in un milione di essi, perché questo numero è importante e quali limiti nessuno mostra nelle presentazioni di marketing.
Cos’è davvero una finestra di contesto
Token, non parole
Un token è l’unità che il modello legge — circa 3-4 caratteri in inglese, ovvero circa 0,7 parole. La finestra di contesto è il numero totale di token che il modello può contenere contemporaneamente; tutto ciò che segue pesa sullo stesso budget:
- Il prompt o la domanda corrente
- L’intera cronologia della conversazione fino a quel momento
- Documenti, codice o trascrizioni incollati
- Le istruzioni di sistema che definiscono il comportamento del modello
- I risultati degli strumenti accumulati da un agente durante un’attività
Si tratta di un’unità diversa dal conteggio delle parole, motivo per cui “1 milione di token” e “1 milione di parole” non sono la stessa cosa — la tokenizzazione e la lunghezza del contesto sono definite allo stesso modo nella maggior parte delle architetture transformer moderne.
Perché la finestra ha un limite rigido
Tutto ciò che il modello “vede” in un turno risiede all’interno di questa finestra; nulla al di fuori esiste per quella risposta. Quando viene superata, i token più vecchi escono dal campo visivo. Non c’è memoria parziale oltre il margine — è un limite netto, non una dissolvenza graduale.
| Dimensione della finestra | Parole approssimative | Pagine approssimative |
|---|---|---|
| 8.000 token | ~6.000 parole | ~20 pagine |
| 128.000 token | ~96.000 parole | ~320 pagine |
| 1.000.000 token | ~750.000 parole | ~2.500 pagine |
Cosa entra in 1 milione di token
1 milione di token equivale a circa 750.000 parole, circa 2.500 pagine, o all’incirca 8 romanzi tascabili di lunghezza media messi in fila. In termini concreti, un milione di token è sufficiente a contenere:
- Un’intera codebase di produzione da 50.000–100.000 righe
- Un anno di messaggi Slack per un team di 20 persone
- Un intero set di documenti annuali per la conformità normativa o le policy
- Diverse centinaia di contratti PDF brevi, affiancati
- Un’intera saga di romanzi, non solo un singolo libro
La scala, calibrata
Numeri come “un milione di token” sono difficili da visualizzare finché non vengono ancorati a qualcosa di concreto. Accostato a una codebase o a un set di contratti, lo stesso numero diventa un parametro progettuale: quanto del lavoro reale entra in un’unica richiesta e quanto richiede ancora di essere suddiviso.
Da frammenti a oggetti interi
Il cambiamento pratico è architetturale: invece di spezzare una codebase o un contratto in parti, si carica l’intero documento in una volta sola e si interroga l’insieme. Una chiamata di funzione e la sua definizione, o una clausola e l’allegato a cui fa riferimento, rimangono nella stessa richiesta anziché finire in frammenti separati che non vengono mai confrontati direttamente.
Perché questo numero è importante
Ragionamento su interi repository e corpus. Si può caricare un intero repo per una revisione architetturale, o un set completo di policy per domande sulla conformità, senza suddivisione tramite RAG. Il ragionamento tra file migliora perché nulla viene diviso prima che il modello lo veda — un bug che si estende su tre file diventa visibile in un unico passaggio.
Agenti a lungo termine. Un agente può eseguire un flusso di lavoro da 50 passaggi, accumulare tutti i risultati degli strumenti e fare ancora riferimento a una decisione presa al passaggio 3 mentre esegue il passaggio 47. Un contesto ampio è ciò che rende pratici gli agenti duraturi e con stato.
Accesso più diffuso a questa scala. Molti modelli open-weight distribuiscono ora finestre di contesto ampie come impostazione predefinita anziché come livello premium, una delle tendenze trattate nella guida di questo sito sui modelli AI open-weight.
Per mettere in pratica tutto questo:
- Identifica l’oggetto completo su cui vuoi ragionare — un repo, un set di contratti, un archivio documentale.
- Stima il conteggio dei token (circa 1,3 token per parola) e verifica che rientri nel limite del modello.
- Caricalo per intero invece di pre-suddividerlo.
- Metti le informazioni più importanti all’inizio o alla fine del prompt, non sepolte nel mezzo.
- Fai la domanda trasversale che non avresti potuto fare con il solo recupero.
- Verifica la risposta rispetto a un fatto noto dalla parte centrale dell’input, non solo dai bordi.
- Se la precisione cala sui contenuti centrali, ristruttura il prompt in modo che il materiale critico si trovi vicino all’inizio o alla fine.
I limiti che nessuno mostra nelle slide
Perso nel mezzo
I modelli non prestano attenzione in modo uniforme su un input lungo. La precisione è massima per i contenuti vicini all’inizio e alla fine della finestra; le informazioni sepolte nel mezzo possono degradarsi del 30% o più nelle attività di recupero multi-elemento. Mettere il contesto critico all’inizio o alla fine è una scelta architetturale, non un semplice suggerimento di prompt. Questo deriva dal modo in cui l’attenzione nei transformer pondera i token tra loro anziché trattare ogni posizione in modo identico.
Latenza, costo e KV cache
Riempire una finestra da un milione di token aumenta il tempo al primo token e il costo, e gonfia la KV cache che il modello mantiene in memoria durante la generazione. Architetture sparse come la mixture of experts aiutano a mantenere economica l’inferenza con contesti lunghi, attivando solo un sottoinsieme di parametri per token. Questo è anche il motivo per cui i design di attention efficienti sono importanti per il costo su larga scala — vedi l’analisi di questo sito su Kimi Delta Attention.
| Fattore | Contesto ridotto (8K–32K) | Contesto ampio (1M) |
|---|---|---|
| Tempo al primo token | Basso | Più alto |
| Costo per richiesta | Basso | Più alto |
| Ragionamento tra documenti | Limitato dalla suddivisione | Intero corpus visibile |
| Precisione sui fatti nascosti | Meno problematica a scala ridotta | Rischio “perso nel mezzo” |
Niente di tutto ciò rende il contesto ampio impraticabile — ha semplicemente una curva di costo che vale la pena gestire:
- Il caching del prompt, in modo che le istruzioni di sistema ripetute e il materiale di riferimento non vengano rielaborati a ogni chiamata
- Architetture sparse o mixture-of-experts che attivano solo una parte del modello per token
- La riduzione della cronologia della conversazione invece di reinviare l’intera trascrizione a ogni turno
- Il riepilogo dei risultati degli strumenti più vecchi nei loop di agenti a lungo termine invece di conservare ogni risultato grezzo
Il costo scala in base a quanta parte della finestra viene effettivamente riempita, non alla dimensione massima; quindi una richiesta che usa 50.000 degli un milione di token disponibili costa all’incirca quanto una richiesta da 50.000 token.
I ricercatori hanno documentato direttamente l’effetto “perso nel mezzo” in uno studio molto citato sui modelli linguistici con contesto lungo:
Rileviamo che le prestazioni possono degradarsi significativamente al variare della posizione delle informazioni rilevanti, a indicare che i modelli linguistici attuali non sfruttano in modo robusto le informazioni presenti in contesti di input lunghi.Liu et al., “Lost in the Middle: How Language Models Use Long Contexts”
Contesto ampio vs RAG
Quando caricare tutto è la scelta giusta
Per corpus piccoli e statici, il caricamento a contesto pieno è più semplice della generazione aumentata dal recupero e spesso produce risultati migliori, poiché non c’è un passaggio di recupero che può perdere un frammento rilevante. Usa l’approccio più semplice che soddisfa il requisito, invece di costruire una pipeline di recupero per un set di documenti che entra già in un unico prompt.
Quando il RAG vince ancora
Per knowledge base enormi, aggiornate di frequente o in continua evoluzione — e per sistemi conversazionali a bassa latenza — il recupero mirato batte ancora il caricamento di un milione di token a ogni turno. Il RAG tende a prevalere quando:
- La knowledge base è molto più grande di qualsiasi finestra di contesto, anche da un milione di token
- I contenuti cambiano frequentemente e la re-indicizzazione è più efficiente del re-invio dell’intero corpus
- La latenza delle risposte è più importante del ragionamento esaustivo tra documenti
- Solo una piccola porzione mirata del corpus è rilevante per ogni singola query