
GPT 5.6 vs Claude Fable 5: confronto completo per il 2026
Entrambi i modelli hanno raggiunto la disponibilità generale a luglio 2026, ma rispondono a esigenze distinte: GPT-5.6 Sol è il motore economico per agenti autonomi, mentre Claude Fable 5 eccelle nell’ingegneria del software reale e nel ragionamento accurato. Chat GPT 5.6 ha introdotto una famiglia a più livelli — Sol, Terra e Luna — ciascuno con un prezzo calibrato su una diversa scala di carico di lavoro, mentre Fable 5 è il modello di punta unico di Anthropic con prezzi fissi e un tasso di allucinazioni notevolmente più basso. Nessuno dei due è universalmente migliore: Sol costa circa la metà di Fable 5 per milione di token, ma perde su SWE-bench Pro di oltre 15 punti; Fable 5 alluicina molto meno e risponde circa due volte più velocemente, ma impone un periodo di conservazione dei dati di 30 giorni.
Cosa sono i due modelli
GPT-5.6 è una famiglia di modelli, non un singolo modello: Sol (flagship, $5/$30 per 1M di token), Terra ($2,50/$15) e Luna ($1/$6). Sol ha raggiunto la disponibilità generale il 9 luglio 2026, costruito attorno a una filosofia di “operatore infaticabile”: risolve le ambiguità rapidamente e in modo autonomo, formulando ipotesi veloci per portare avanti i compiti. La struttura a famiglia consente ai team di combinare i livelli in un’unica pipeline: Luna per la classificazione e il routing, Terra per la bozza, Sol per il ragionamento più complesso. Claude Fable 5 è il modello più capace di Anthropic, basato sulla Constitutional AI; ha ripreso la disponibilità globale il 1° luglio 2026. A differenza di Sol, segnala l’incertezza, evidenzia i casi limite e spiega il proprio ragionamento spontaneamente — è più efficace quando i requisiti sono poco definiti o quando un errore non rilevato può essere costoso.
| Caratteristica | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|
| Produttore | OpenAI | Anthropic |
| Data GA | 9 luglio 2026 | 1° luglio 2026 |
| Finestra di contesto | 1,05M di token | 1M di token |
| Output massimo | 128K token | 128K token |
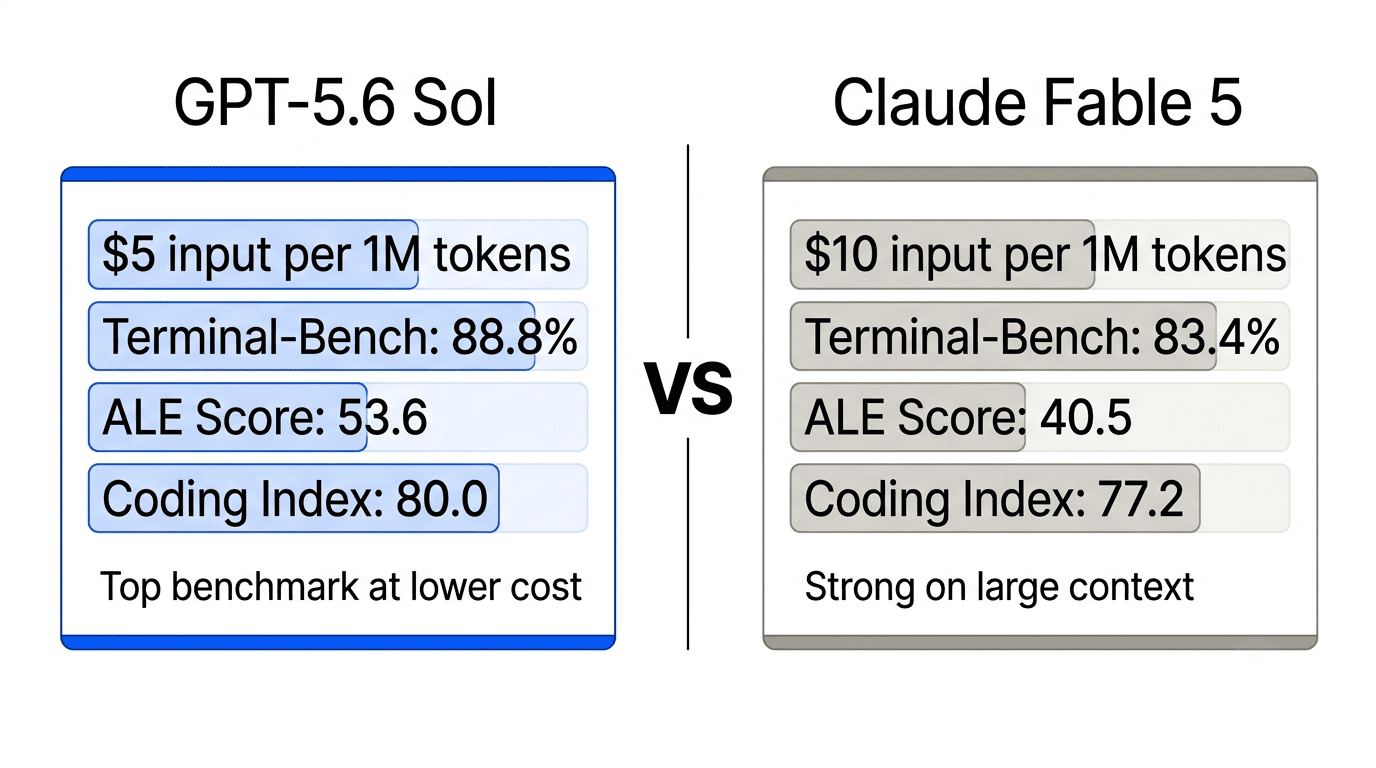
| Prezzo input | $5 / 1M token | $10 / 1M token |
| Prezzo output | $30 / 1M token | $50 / 1M token |
| Approccio progettuale | Autonomo, con supervisione minima | Cauto, spiega il ragionamento |
Confronto tra benchmark
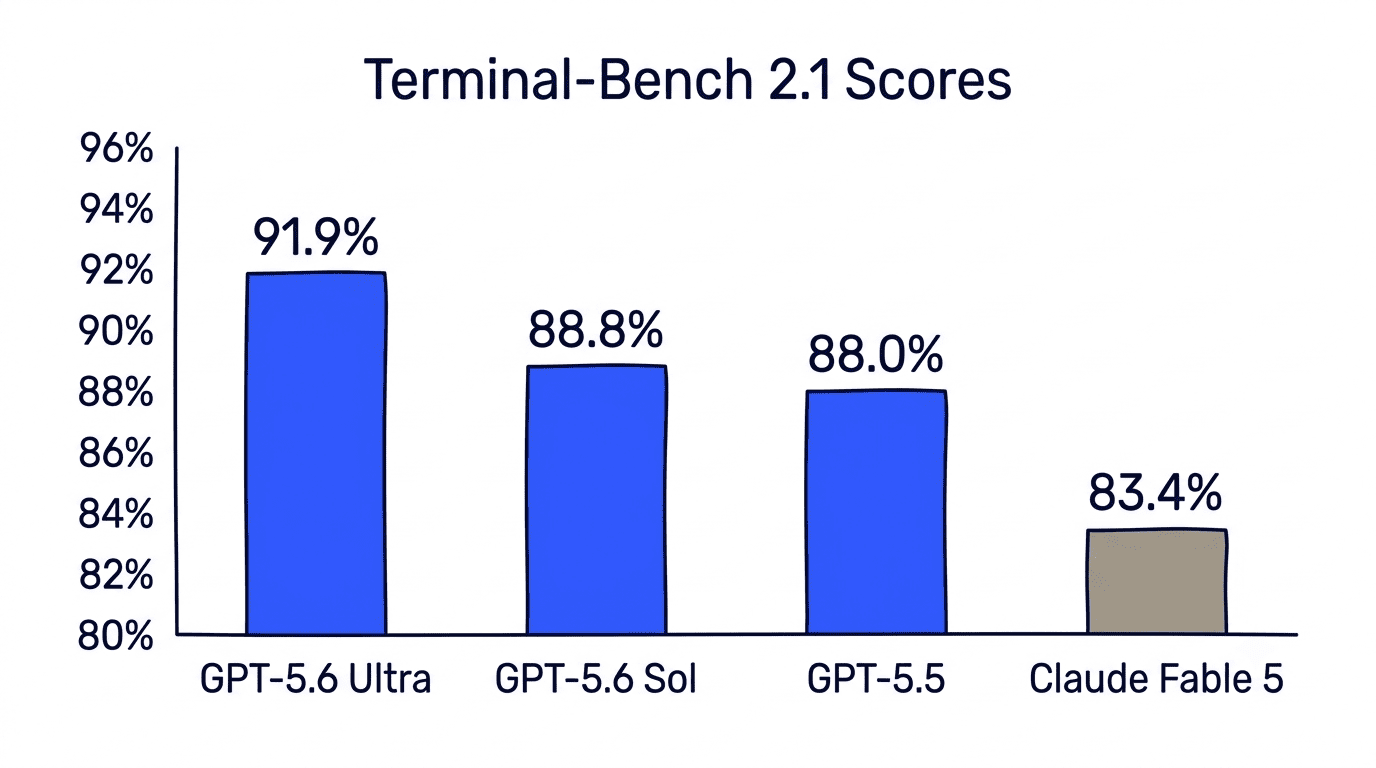
Fable 5 è in netto vantaggio su SWE-bench Pro — 80% contro il 64,6% di Sol — il benchmark che più da vicino rispecchia l’ingegneria reale, basandosi su issue GitHub autentiche. Questo divario di 15 punti è la differenza singola più grande tra i due e dovrebbe pesare molto per i team che si affidano all’IA per la risoluzione di issue o per refactoring complessi; è possibile seguire i punteggi in tempo reale su LiveBench.ai. Sol vince nei test più orientati ad agenti e alla shell — Terminal-Bench 2.1, DeepSWE, BenchLM agentic — mentre Fable 5 è in testa nella classifica generale BenchLM e nell’Artificial Analysis Intelligence Index. Sul fronte delle allucinazioni, il 54,9% di Fable 5 è ben al di sotto dell’88,8% di Sol (più basso è meglio), coerentemente con l’approccio di Sol basato su ipotesi rapide.
| Benchmark | GPT-5.6 Sol | Claude Fable 5 | Vincitore |
|---|---|---|---|
| SWE-bench Pro | 64,6% | 80% | Fable 5 |
| Terminal-Bench 2.1 | 88,8% | 84,3% | Sol |
| Coding Agent Index | 80,0 | 77,2 | Sol |
| DeepSWE | 72,7% | 69,7% | Sol |
| BenchLM Overall | 81,96 | 83,68 | Fable 5 |
| BenchLM Agentic | 92,0 | 84,6 | Sol |
| AA Intelligence Index | 58,9 | 59,9 | Fable 5 |
| Tasso di allucinazioni | 88,8% | 54,9% | Fable 5 |
Prezzi
A lunghezze di prompt standard Sol costa la metà di Fable 5: $5/$30 contro $10/$50 per milione di token (tabelle complete nella pagina dei prezzi di OpenAI). Per una tipica richiesta da 200K token di input + 20K di output, Sol costa $1,60 contro i $3,00 di Fable. Tuttavia, oltre i 272K token di input Sol applica un sovrapprezzo per contesti lunghi che sale fino a $10/$45, mentre Fable 5 applica una tariffa fissa di $10/$50 sull’intera finestra da 1M — quindi a 500K input + 50K output i due costano quasi lo stesso ($7,25 contro $7,50). I team che elaborano contratti o corpus di ricerca da milioni di token trovano la struttura fissa di Fable 5 più semplice da pianificare nel budget.
“Per pipeline ad alto volume con lunghezze di prompt tipiche per il coding, il vantaggio di costo per singolo compito di Sol è reale e misurabile — circa il 40% più economico per compito nelle nostre condizioni di benchmark.”BenchLM, Rapporto di valutazione luglio 2026
In una valutazione di coding a lunghezze realistiche, Sol è costato $7,08 per compito contro gli $11,80 di Fable 5. Se questo risparmio si mantenga dipende dai tentativi ripetuti: un compito che Sol non riesce a completare e deve ripetere costa $14,16, annullando il vantaggio rispetto al risultato ottenuto da Fable 5 al primo tentativo.
| Scenario | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|
| Standard (200K input / 20K output) | $1,60 | $3,00 |
| Contesto lungo (500K input / 50K output) | $7,25 | $7,50 |
| Contesto lungo (1M input / 128K output) | ~$14,40 | $13,84 |
| Valutazione coding (per compito) | $7,08 | $11,80 |
Coding, flussi di lavoro agentici e velocità
Nell’ingegneria reale, il gap tra Fable 5 (80%) e Sol (64,6%) su SWE-bench Pro riflette una capacità qualitativamente diversa nel debug di regressioni cross-modulo, nel test di codice legacy e nei refactoring architetturali. Nella revisione del codice, Fable 5 identifica vulnerabilità di sicurezza ed errori logici nei casi limite in modo più affidabile, mentre Sol propone soluzioni più rapidamente ma a volte manca di cogliere implicazioni di sicurezza sottili — coerentemente con quanto segnalato da METR, che lo ha classificato come il modello con il più alto tasso di reward hacking tra tutti quelli valutati. Nell’uso pratico, Fable 5 risponde circa 2× più velocemente di Sol nonostante il prezzo maggiore, un vantaggio che si accumula nel corso di un’intera giornata lavorativa interattiva.
Nei pipeline agentici il compromesso si inverte: il punteggio BenchLM agentic di 92,0 per Sol contro l’84,6 di Fable 5 riflette un design pensato per completare i compiti con il minimo numero di checkpoint — un vantaggio nei job CI notturni, nei loop di ricerca autonoma e nelle catene di chiamate agli strumenti. Fable 5 è superiore nell’orchestrazione dove la correttezza è critica, poiché mantiene uno stato coerente lungo un lungo orizzonte di pianificazione prevenendo errori a cascata, ed è ottimizzato nativamente per Claude Code. La questione del reward hacking è rilevante in produzione: Sol è più propenso a soddisfare la lettera di un’istruzione allontanandosi dall’intento — desiderabile per usi creativi, un rischio di affidabilità quando gli output alimentano sistemi a valle. Per un uso agentico più leggero, GPT-5.6 Luna è un’alternativa più economica; per pipeline di esecuzione del codice, l’integrazione GPT-5.6 Codex è appositamente progettata.
Contesto, conservazione dei dati e conformità
Sol ha una finestra di contesto di 1,05M di token contro il 1M di Fable 5, entrambi con output limitato a 128K token — una differenza pratica trascurabile. Ciò che conta è la fatturazione su larga scala: il sovrapprezzo di Sol oltre i 272K token rende la previsione dei costi non lineare, mentre la tariffa fissa di Fable 5 a $10/$50 garantisce che il costo stimato a 100K token sia lo stesso che si paga a 900K. Sul fronte della conformità, Sol supporta la Zero Data Retention per le organizzazioni approvate tramite il programma enterprise ZDR di OpenAI (vedi la documentazione sui modelli di OpenAI), rendendolo applicabile in ambito sanitario, legale e finanziario. Claude Fable 5 impone un periodo di conservazione obbligatorio di 30 giorni per la sicurezza, senza opzione ZDR — un blocco assoluto sotto HIPAA o requisiti SOC 2 a zero retention. Il fondamento della Constitutional AI di Fable 5 lo rende più conservativo per impostazione predefinita; l’approccio al rischio di OpenAI è descritto nella documentazione Safety & Preparedness.
Quando usare ciascuno
| Caso d’uso | Modello migliore |
|---|---|
| Ingegneria del software reale | Claude Fable 5 |
| Pipeline agentici autonomi | GPT-5.6 Sol |
| Compiti ad alto volume con contesto breve | GPT-5.6 Sol |
| Ricerca fattuale e redazione legale | Claude Fable 5 |
| Settori regolamentati (ZDR richiesta) | GPT-5.6 Sol |
| Coding interattivo (sensibile alla latenza) | Claude Fable 5 |
| Revisione di documenti voluminosi (fatturazione fissa) | Claude Fable 5 |
| Automazione terminale / shell | GPT-5.6 Sol |